如何将 AdsCrawl 与 Cloudflare 开发者文档配合使用
了解如何将 AdsCrawl 的浏览器自动化 API 与 Cloudflare 开发者文档结合使用,以抓取渲染后的开发者文档并构建可靠的 AI 上下文管道。
如何将 AdsCrawl 与 Cloudflare 开发者文档配合使用
开发者文档是 AI 代理、代码助手和内部知识库最有价值的上下文来源之一。它也是最难可靠收集的来源之一:文档站点大量使用 JavaScript、分页、版本化,并且越来越多地受到机器人缓解措施的保护。Cloudflare 开发者文档发布了 Cloudflare 开发者平台和边缘基础设施的参考材料,而 AdsCrawl 提供了浏览器自动化层,将这些页面转换为干净、结构化的输出。
本指南解释了二者如何配合、工作流程和设置步骤、实际示例以及该组合解决的问题。本文面向构建 AI 上下文管道、文档镜像或自动化变更跟踪的开发者。
为什么将 AdsCrawl 与 Cloudflare 开发者文档配对
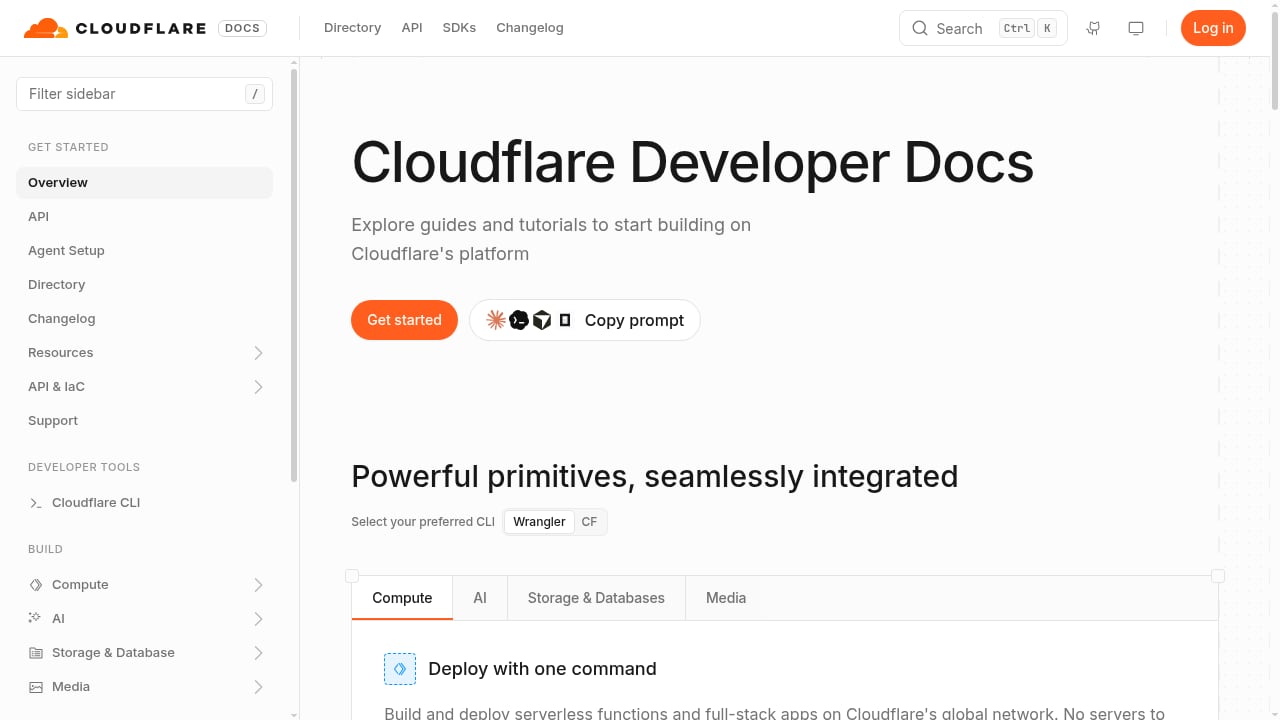
First viewport screenshot of developers.cloudflare.com.
developers.cloudflare.com 的首屏截图。
Cloudflare 开发者文档是 Cloudflare 开发者平台工作原理的权威来源:Workers、Pages、R2、D1、KV、Durable Objects 以及更广泛的边缘基础设施栈。如果你在该平台上构建,或构建一个回答相关问题的 AI 代理,你需要机器可读形式的文档。
挑战在于文档站点不是静态 HTML 文件。许多站点在客户端渲染导航、代码示例和版本选择器。有些应用速率限制或机器人挑战。普通的 HTTP 抓取通常返回页面外壳,而不是你需要的内容。
AdsCrawl 通过真实的浏览器环境解决这个问题。它提供用于截图、渲染 HTML、Markdown 和 SPA 提取的同步端点,以及可连接到 Playwright、Puppeteer 或原始 CDP 客户端的有状态远程 Chromium 会话。对于文档工作,Markdown 端点通常最有用:它返回渲染后页面的可读内容,而不包含导航外壳。
分工很明确:
- Cloudflare 开发者文档 是平台行为、API 参考和配置示例的真实来源。
- AdsCrawl 是检索和渲染层,以可用的格式大规模提取内容而不被阻止。
每个产品贡献什么
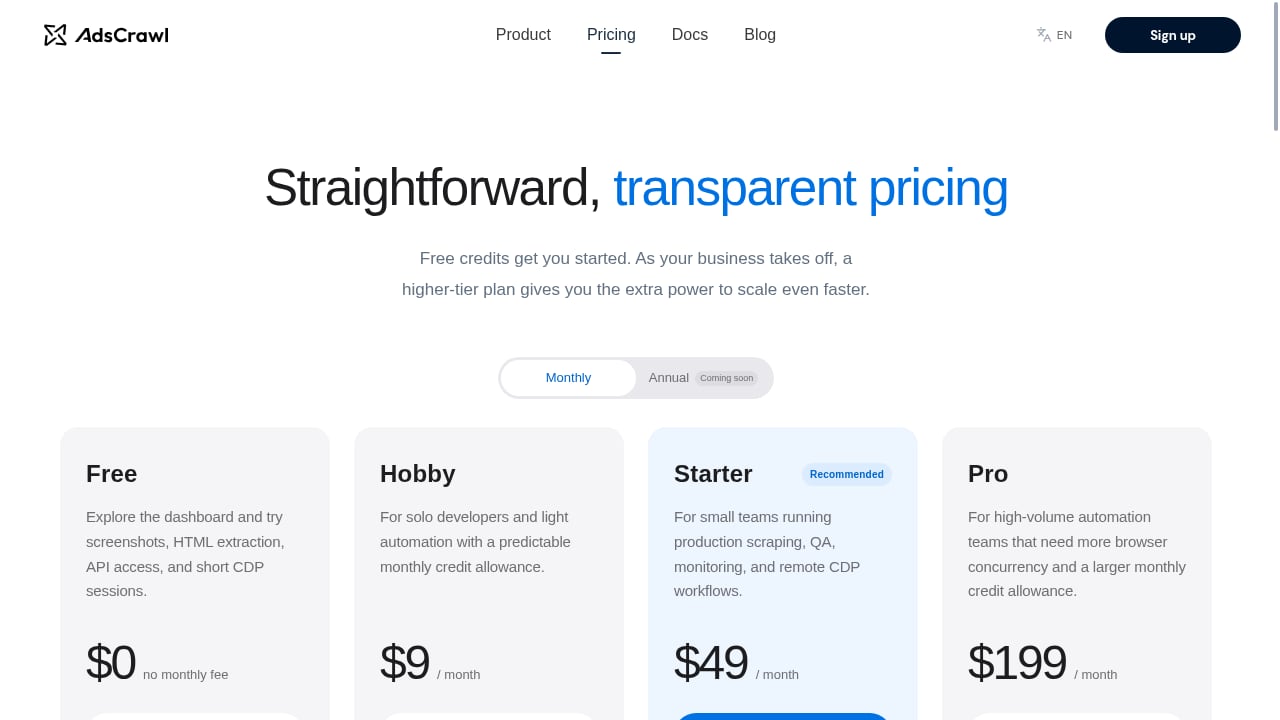
First viewport screenshot of www.adscrawl.net.
www.adscrawl.net 的首屏截图。
Cloudflare 开发者文档:参考层
Cloudflare 开发者文档按产品和任务组织文档。它涵盖开发者平台的配置、限制、定价和代码示例。对于 AI 上下文管道,文档很有价值,因为它们具有权威性且频繁更新。它们还包括一个 llms.txt 索引,旨在帮助 AI 系统发现和导航文档结构。
AdsCrawl:渲染和提取层
AdsCrawl 是一个浏览器自动化 API 和云浏览器平台。其与文档工作相关的能力包括:
- 用于渲染 HTML、Markdown、JSON 和截图的同步端点。
- 用于多步骤工作流的有状态远程 Chromium 会话。
- 托管浏览器身份、随机 User-Agent、可信代理和住宅代理路由。
- 用于地理特定内容的动态区域路由。
- 保存的云浏览器配置文件,具有生命周期管理和交互式查看器访问。
- 用于其自身文档的 OpenAPI 规范和 AI 友好的
llms.txt索引。
对于文档抓取,渲染 Markdown 输出和代理路由的结合使工作流在大规模下变得实用。
工作流程:从文档 URL 到结构化上下文
First viewport screenshot of developers.cloudflare.com.
developers.cloudflare.com 的首屏截图。
一个可靠的文档管道有五个阶段。每个阶段对应 AdsCrawl 中的特定能力。
阶段 1:发现文档结构
从 Cloudflare 开发者文档发布的 llms.txt 索引开始。它列出了主要的文档部分,并为你提供了站点地图。使用它来构建种子 URL 列表,而不是盲目爬取。
如果你需要跟随客户端渲染的导航链接,使用 AdsCrawl 的渲染 HTML 端点捕获 JavaScript 执行后的页面,然后从该输出中解析链接。
阶段 2:在真实浏览器中渲染每个页面
对于种子列表中的每个 URL,从 AdsCrawl 请求 Markdown 输出。这会在浏览器执行 JavaScript 后返回页面的可读内容。你避免了静态抓取返回加载外壳或部分页面的常见故障模式。
阶段 3:规范化和分块内容
Markdown 输出比原始 HTML 更容易分块。按标题结构拆分内容,使每个块对应文档的一个部分。保留源 URL 和页面标题作为元数据,以便下游检索可以引用原始页面。
阶段 4:存储和索引
将规范化后的块存储在你的向量存储、搜索索引或知识库中。如果你在 Cloudflare 本身上构建,Workers KV、R2 或 D1 是自然的存储目标。托管文档的同一平台可以托管你的上下文管道。
阶段 5:按计划刷新
文档会变化。安排定期重新抓取,并比较 Markdown 输出的哈希值以检测变化。仅重新索引实际更改的页面。这可以保持上下文新鲜,而无需重新处理整个站点。
设置步骤
步骤 1:获取 AdsCrawl API 密钥
注册 AdsCrawl 账户。新账户获得 500 个免费积分,足以在承诺付费计划之前测试文档抓取。Free、Hobby、Starter 和 Pro 计划基于积分,因此你可以随着抓取量的增长而扩展。
步骤 2:选择你的端点
对于大多数文档工作,Markdown 端点是正确的选择。当你需要检查 DOM 或提取结构化数据(如导航树)时,使用渲染 HTML 端点。当你需要页面布局的视觉验证时,使用截图。
步骤 3:配置代理和区域
如果文档站点应用地理特定行为或机器人缓解,在请求中配置住宅代理路由和动态区域路由。AdsCrawl 的托管浏览器身份和随机 User-Agent 有助于请求看起来像正常的浏览器流量。
步骤 4:构建抓取循环
遍历你的种子 URL,为每个调用 AdsCrawl 端点,并将输出写入你的存储层。添加重试和速率限制,以保持在积分预算内并避免压垮目标站点。
步骤 5:验证输出
抽查页面样本。确认代码块、表格和标题在转换后保留。Markdown 转换偶尔会扁平化复杂表格,因此请特别验证这些页面。
实际示例
示例 1:为 Cloudflare Workers 构建 AI 助手
假设你正在构建一个回答有关部署 Workers 问题的内部助手。你需要 Workers 文档、运行时 API 参考和相关配置页面。
- 拉取
llms.txt索引以识别 Workers 部分。 - 使用 AdsCrawl 的 Markdown 端点抓取每个页面。
- 按标题分块并存储源 URL。
- 将索引连接到你的检索层。
当开发者询问如何配置绑定时,助手检索相关块并引用原始文档页面。
示例 2:跟踪文档变更
平台频繁更新文档。如果你的产品与 Cloudflare 集成,你希望知道相关页面何时更改。
- 每周使用 AdsCrawl 抓取目标页面。
- 对每个页面的 Markdown 输出进行哈希。
- 将哈希值与上一次运行进行比较。
- 对更改的页面发送差异通知。
这是一个轻量级的变更检测系统,不需要解析完整的 HTML 差异。
示例 3:多区域文档验证
一些文档包含区域特定的限制或可用性说明。使用 AdsCrawl 的动态区域路由从不同区域获取同一页面并比较渲染输出。这揭示了单区域抓取会遗漏的区域差异。
该组合解决的问题
| 问题 | 该组合如何解决 |
|---|---|
| JavaScript 渲染的文档返回空外壳 | AdsCrawl 在提取前在真实浏览器中渲染页面 |
| 机器人缓解阻止自动抓取 | 托管浏览器身份、随机 User-Agent 和住宅代理 |
| 原始 HTML 难以分块 | Markdown 输出保留结构,更易于拆分 |
| 内容静默更改 | 定期重新抓取并通过哈希比较检测更新 |
| 区域差异不可见 | 动态区域路由获取地理特定变体 |
| 多步骤认证文档 | 有状态远程 Chromium 会话保持会话状态 |
何时使用 AdsCrawl 与更简单的方法
First viewport screenshot of www.adscrawl.net.
www.adscrawl.net 的首屏截图。
并非每个文档管道都需要完整的浏览器自动化 API。使用此决策指南:
- 无机器人保护的静态 HTML 文档: 简单的 HTTP 客户端和 HTML 解析器可能就足够了。
- JavaScript 渲染的文档: 使用 AdsCrawl 的 Markdown 或渲染 HTML 端点。
- 受机器人缓解或速率限制保护的文档: 使用带代理路由的 AdsCrawl。
- 认证或多步骤文档: 使用带 Playwright 或 Puppeteer 的有状态远程 Chromium 会话。
- 大批量重复抓取: 使用付费 AdsCrawl 计划并安排带变更检测的重新抓取。
如果你更广泛地比较浏览器自动化选项,请参阅 AdsCrawl vs Steel vs Zyte 对比 了解 CDP 工作流与托管数据交付的细分。对于会话密集的文档工作流,浏览器自动化中的会话持久性 指南解释了有状态会话如何在步骤之间保持 cookie 和登录状态。
相关阅读
- AdsCrawl vs ScreenshotEngine vs Screenshotlayer:2026 指南 - 比较 AdsCrawl、ScreenshotEngine 和 Screenshotlayer 在截图、浏览器控制和数据提取方面的表现。为你的工作流找到合适的工具。
- AdsCrawl vs Lexmount:面向 AI 代理的云浏览器 API - 比较 AdsCrawl 和 Lexmount Cloud Browser API 面向 AI 代理的表现。了解哪个提供更好的 CDP 控制、数据提取、定价和代理支持。
- Steel 评测:面向 AI 代理的云浏览器基础设施 - 基于证据的 Steel 评测,涵盖理想用户、用例、优势、限制、定价、设置和 AI 代理浏览器基础设施的决策标准。
来源与进一步阅读
- 远程 MCP 服务器 - 官方 Ahrefs MCP 服务器,让 AI 代理通过 Ahrefs API 安全访问 Ahrefs SEO 数据、站点指标、关键词研究和竞争对手分析。
- Agentic Access Index - APIs.io - 浏览 APIs.io 网络中 API 提供商的推荐 x-agentic-access 执行契约——操作类别、后果层级、范围、短期令牌以及 AI 代理可能调用的每个操作的人工介入升级。根据提供商 OpenAPI 按照 Curity 分类
- “客户大脑”如何为 AI 提供 SEO 工作所需的上下文 - 结构化的客户记忆帮助 AI 生成的工作扎根于品牌指南、活动历史和技术限制。
常见问题
什么是 Cloudflare 开发者文档?
Cloudflare 开发者文档是 Cloudflare 开发者平台和边缘基础设施的文档站点。它涵盖 Workers、Pages、R2、D1、KV 和 Durable Objects 等产品,包括配置、限制和代码示例。
AdsCrawl 是否适用于任何文档站点,而不仅仅是 Cloudflare?
是的。AdsCrawl 是一个通用的浏览器自动化 API。这里描述的工作流适用于任何使用 JavaScript 渲染内容或应用机器人缓解的文档站点。Cloudflare 开发者文档只是一个结构良好的示例。
我可以在不编写浏览器自动化代码的情况下使用 AdsCrawl 吗?
是的。用于 Markdown、HTML 和截图的同步端点可以直接通过 HTTP 请求调用。当你需要 Playwright、Puppeteer 或原始 CDP 控制时,可以使用有状态远程 Chromium 会话。
如何保持文档上下文最新?
安排定期抓取并比较运行之间的内容哈希。仅重新索引更改的页面。AdsCrawl 基于积分的计划使成本可预测。
AdsCrawl 自己的文档是否有 AI 友好的索引?
是的。AdsCrawl 发布了 OpenAPI 规范和专为 AI 系统发现和导航其文档而设计的 llms.txt 索引。
如果页面渲染失败会发生什么?
在抓取循环中添加重试和回退逻辑。如果页面持续失败,使用截图或渲染 HTML 请求检查它,以确定问题是机器人缓解、客户端错误还是页面的结构变化。
结论
将 AdsCrawl 与 Cloudflare 开发者文档配对,为你提供了一种可靠的方式,将权威平台文档转换为结构化、机器可读的上下文。AdsCrawl 处理检索的难点:JavaScript 渲染、机器人缓解、代理路由和结构化输出。Cloudflare 开发者文档提供了 AI 代理、代码助手和内部工具准确回答实际问题所需的参考材料。
从 llms.txt 索引开始,使用 Markdown 端点抓取一个小部分,并在扩展之前验证输出。一旦管道稳定,添加变更检测和定期刷新。结果是一个随着平台发展而保持准确的文档上下文层。