
隐蔽式网页抓取:2026 年如何避免被封禁
学习隐蔽式网页抓取技术:浏览器指纹识别、代理、CDP 补丁,以及如何构建可大规模避免封禁的可靠抓取器。
隐蔽式网页抓取:2026 年如何避免被封禁
隐蔽式网页抓取是指在不触发反机器人系统的前提下采集公开网页数据的实践。它结合了浏览器指纹管理、代理轮换和请求级别的真实性,让你的抓取器看起来像普通访客,而不是自动化工具。
本指南将解释抓取器为什么会被封禁、哪些技术真正有效,以及如何在自建技术栈和使用托管浏览器 API 之间做出选择。
抓取器为什么会被封禁
隐蔽式网页抓取:2026 年如何避免被封禁 - 抓取器为什么会被封禁.
隐蔽式网页抓取:2026 年如何避免被封禁 - 抓取器为什么会被封禁。
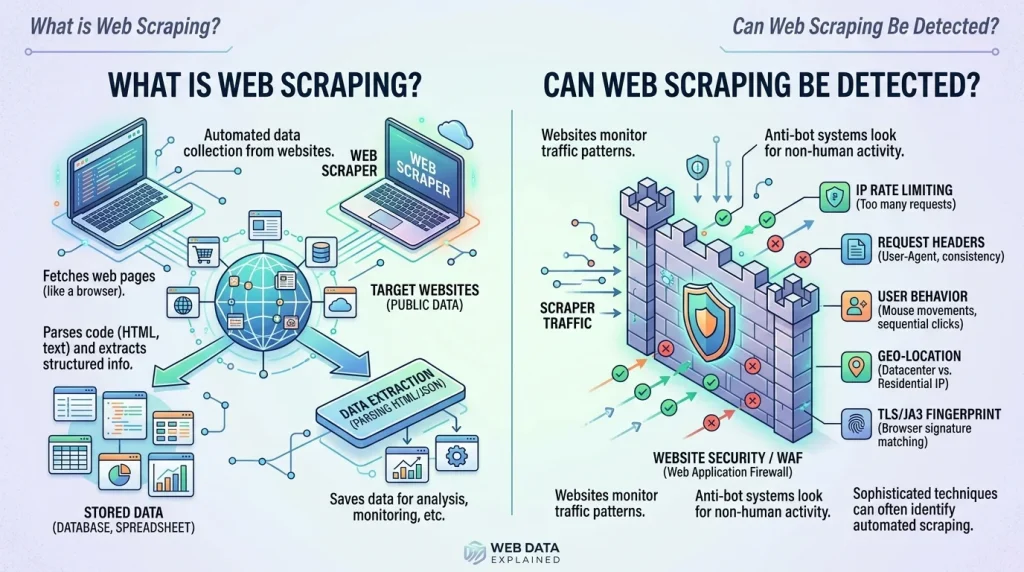
现代机器人防护系统(Cloudflare、DataDome、Akamai、PerimeterX)检查的远不止你的 IP 地址。它们会使用以下信号对每个请求进行评分:
- TLS/JA3 指纹 — 你的 HTTP 客户端的握手模式。Python
requests和原生curl的签名与真实 Chrome 不同。 - HTTP 头部顺序和值 — 缺少
Accept-Language、User-Agent不一致,或头部顺序与真实浏览器不匹配。 - JavaScript 执行 — 许多防护系统会运行只有真实浏览器才能解决的 JS 挑战。
- 浏览器指纹 — canvas、WebGL、字体、屏幕尺寸、时区,以及通过
navigator和window暴露的数十种其他属性。 - 行为信号 — 鼠标移动、滚动深度、请求之间的时间间隔。
- IP 信誉 — 数据中心 IP 段会被标记;住宅和移动 IP 更受信任。
只轮换 User-Agent 字符串的抓取器,面对任何严肃的机器人防护系统都会失败。隐蔽式抓取会逐层应对这些问题。
隐蔽式网页抓取的核心技术
隐蔽式网页抓取:2026 年如何避免被封禁 - 隐蔽式网页抓取的核心技术.
隐蔽式网页抓取:2026 年如何避免被封禁 - 隐蔽式网页抓取的核心技术。
1. 使用真实浏览器自动化,而不是原始 HTTP
无头 Chrome(通过 Playwright、Puppeteer 或直接 CDP)会执行 JavaScript、渲染页面,并产生逼真的 TLS 指纹。问题在于:默认无头模式会泄露 navigator.webdriver = true 和缺少插件等信号。
缓解措施包括:
- 使用
--disable-blink-features=AutomationControlled启动 - 修补
navigator.webdriver、navigator.plugins和navigator.languages - 使用 CDP 级别的补丁(nodriver 等工具采用的方法),而不是可能被检测到的 JS 注入
如果你正在比较 API 驱动的浏览器和框架,请参阅 AdsCrawl vs Scrapfly vs Playwright:哪个适合你的技术栈?。
2. 住宅代理和移动代理
数据中心 IP 便宜,但会被大量标记。住宅代理通过真实 ISP 分配的地址进行路由,移动代理则通过运营商网络。正如 Medium 开发者指南 所指出的,住宅 IP 由 ISP 分配给真实房主,因此它们能通过数据中心 IP 段无法通过的信誉检查。
实用规则:
- 根据目标按请求或按会话轮换 IP
- 粘性会话对多步骤流程(登录、购物车、分页)很重要
- 让代理地理位置与目标网站的预期受众相匹配
你可以将 AdsCrawl 的浏览器会话与代理网络结合使用——有关可用的设置,请参阅 如何将 AdsCrawl 与 Bright Data 一起使用。
3. 浏览器指纹一致性
隐蔽式浏览器必须呈现连贯的指纹。每个请求都随机化所有属性,比使用一个一致、真实的配置文件更糟。需要对齐的关键属性:
| 属性 | 为什么重要 |
|---|---|
| User-Agent | 必须与实际 Chrome 版本和平台匹配 |
| 时区 | 应与代理的地理位置匹配 |
| 语言 | 应与目标网站的区域设置匹配 |
| 屏幕/视口 | 仅使用常见分辨率;避免 0x0 或奇怪尺寸 |
| WebGL/canvas | 必须产生稳定、非无头的哈希 |
| 字体 | 无头容器通常只附带最小字体集 |
AdsCrawl 提供带有指纹配置文件的云浏览器会话,因此每个会话呈现的是一致身份,而不是拼凑出来的身份。
4. 类人时间安排和交互
即使指纹完美,如果你以每秒 50 个请求猛击网站,也会失败。请添加:
- 操作之间的随机延迟(不是固定的
sleep(1)) - 真实的导航路径(首页 → 分类 → 产品)
- 提取前的滚动和鼠标事件
- 对相关请求复用会话
5. 优雅地处理挑战
有些防护系统仍会发出挑战。一个稳健的流水线应:
- 检测挑战页面(状态码、正文标记或缺少预期元素)
- 等待 JS 挑战在真实浏览器中解决
- 如果失败,使用新的指纹或 IP 重试
- 记录失败以便调试,而不是静默返回空数据
自建还是购买:选择你的隐蔽式技术栈
隐蔽式网页抓取:2026 年如何避免被封禁 - 自建还是购买:选择你的隐蔽式技术栈.
隐蔽式网页抓取:2026 年如何避免被封禁 - 自建还是购买:选择你的隐蔽式技术栈。
| 方案 | 最适合 | 权衡 |
|---|---|---|
| 自托管 Playwright + 代理 | 完全控制、自定义逻辑 | 维护成本高、指纹漂移、基础设施成本 |
| 开源隐蔽式库 | 原型开发、小型任务 | 机器人防护系统更新时会失效 |
| 托管抓取 API | 规模、可靠性、团队 | 控制较少、按使用量定价 |
| 浏览器自动化 API(AdsCrawl) | AI 代理、监控、截图、HTML/Markdown 提取 | 需要 API 集成 |
如果你正在评估托管方案,AdsCrawl vs Browserless vs ScrapingBee 详细比较了浏览器控制、并发和定价方面的差异。
AdsCrawl 适合的场景
AdsCrawl 通过统一 API 提供真实浏览器会话。你可以:
- 捕获截图以验证渲染状态
- 从渲染后的页面提取 HTML 或 Markdown
- 直接控制远程 Chrome DevTools Protocol(CDP)会话
- 使用指纹配置文件运行并发浏览器会话
- 将可重复的网页操作封装为可靠的 API,供 AI 代理和监控工作流使用
它通过 cURL、Node.js 和 Python 集成,并提供用于密钥管理、使用跟踪和调试的仪表板。对于已经使用代理的团队,AdsCrawl 处理浏览器层,而你的代理提供商处理 IP 信誉。
实用示例:Python 中的最小隐蔽式请求
import requests

API_KEY = "your_adscrawl_key"

payload = {
    "url": "https://example.com/product/123",
    "format": "markdown",
    "fingerprint_profile": "chrome_win_us"
}

resp = requests.post(
    "https://api.adscrawl.com/v1/extract",
    headers={"Authorization": f"Bearer {API_KEY}"},
    json=payload,
    timeout=60
)

print(resp.json()["markdown"])
同样的模式也适用于截图(将 format 换成 screenshot)或原始 HTML。由于浏览器在远程以一致的指纹运行,你可以完全避免本地无头检测问题。
破坏隐蔽性的常见错误
- 按请求轮换 User-Agent — 会创建不可能的指纹历史
- 在一个会话中混用数据中心和住宅 IP — 会破坏会话一致性
- 忽视
robots.txt和速率限制 — 会导致法律和伦理问题,并更快被封禁 - 不验证提取的数据 — 你可能正在抓取挑战页面却没有察觉
- 硬编码选择器 — 网站会变化;使用有弹性的提取方式或 Markdown 输出
相关阅读
- 2026 年十大竞品价格监控与重新定价软件 - 比较 2026 年十大竞品价格监控与重新定价软件。功能、定价、匹配准确性和最适合的用例。
- AdsCrawl vs Octoparse vs axiom.ai:哪个适合你的工作流? - 在浏览器自动化、抓取和 AI 工作流方面比较 AdsCrawl、Octoparse 和 axiom.ai,为你的技术栈选择合适工具。
- AdsCrawl vs ParseHub:API 浏览器自动化还是可视化抓取器? - 比较 AdsCrawl 和 ParseHub:API 驱动的浏览器自动化与可视化无代码抓取器。看看哪个适合 AI 代理、监控和数据管道。
来源与延伸阅读
- 在抓取网页时保持不被检测 | 开源项目 - 2024 年 9 月 11 日……大家好,我刚发布了新的开源项目 Stealth-Requests!Stealth-Requests 是一个用于网页抓取的一体化解决方案……
- Stealth-Scraper — 为 AI 代理提供结构化网页数据 - 指向并点击,或描述你想要的内容。从任何页面获取干净的 JSON。
常见问题
什么是隐蔽式网页抓取?
隐蔽式网页抓取是一组技术,用于在不被反机器人系统检测和封禁的情况下采集公开网页数据。它包括浏览器指纹管理、代理轮换、逼真的请求模式和挑战处理。
隐蔽式网页抓取合法吗?
在许多司法管辖区,抓取公开数据通常是合法的,但规则各不相同。始终尊重 robots.txt、服务条款、速率限制以及 GDPR 等数据隐私法律。隐蔽式技术应用于避免误报,而不是绕过合法的访问控制。
隐蔽式抓取需要住宅代理吗?
对于有强大机器人防护系统的网站,需要。数据中心 IP 会被广泛标记。住宅或移动代理能显著提高成功率,尤其是与一致的浏览器指纹结合使用时。
Playwright 会被检测到吗?
无头模式下的原生 Playwright 会被大多数现代机器人防护系统检测到。你需要 CDP 级别的补丁、逼真的指纹配置文件,通常还需要代理层。托管浏览器 API 会为你处理这些。
AdsCrawl 如何帮助隐蔽式抓取?
AdsCrawl 提供带有指纹配置文件的真实浏览器会话、远程 CDP 控制和并发执行。它处理浏览器和渲染层,让你专注于提取逻辑,并与代理提供商集成以处理 IP 信誉。
隐蔽式抓取和直接使用 API 有什么区别?
抓取 API 通常会在后台为你处理隐蔽性。自建隐蔽式技术栈提供更多控制,但随着机器人防护系统演进,需要持续维护。正确的选择取决于你的规模、团队和对故障的容忍度。
结论
2026 年的隐蔽式网页抓取是一个分层问题:TLS 指纹、浏览器指纹、IP 信誉和行为信号都很重要。最可靠的方法是将真实浏览器与一致的指纹配置文件、优质代理和优雅的挑战处理结合起来。
如果你想跳过自己修补无头 Chrome 的维护工作,AdsCrawl 的浏览器 API 通过单一集成为你提供真实会话、CDP 访问以及截图/HTML/Markdown 提取。从免费套餐开始,针对最难的目标进行测试,然后逐步扩展。