
如何将 AdsCrawl 与 ScrapeOps 结合使用以实现可靠抓取
将 AdsCrawl 的云浏览器渲染与 ScrapeOps 代理聚合相结合,构建弹性抓取工作流。包含设置步骤、代码和实用示例。
如何将 AdsCrawl 与 ScrapeOps 结合使用以实现可靠抓取
可靠地抓取动态网站需要两个容易分别出错的东西:一个能够渲染 JavaScript 的真实浏览器,以及一个防止请求被阻止的代理层。AdsCrawl 提供前者——托管的云 Chromium 会话,支持住宅代理路由、CDP 访问,并以 HTML、Markdown、JSON 或截图形式返回渲染输出。ScrapeOps 提供后者——一个集成即可聚合 20 多家代理提供商和多个抓取 API,自动为每个站点选择性能最佳的代理,并在某个代理失败时进行回退。
本指南解释了这两个产品如何互补、如何设置组合工作流,以及这种配对能解决哪些单独工具无法处理的问题。
为什么要结合 AdsCrawl 和 ScrapeOps?
First viewport screenshot of scrapeops.io.
scrapeops.io 的首屏截图。
AdsCrawl 已经通过住宅代理路由请求,所以你可能会问为什么还要添加 ScrapeOps。答案在于大规模下的控制和弹性。
- AdsCrawl 处理渲染和浏览器状态。 它启动真实的 Chromium,等待页面达到你请求的加载状态,注入 cookie 和指纹设置,并返回渲染后的 HTML、干净的 Markdown、结构化 JSON 或 PNG。对于多步骤流程,远程 CDP 会话在请求之间保持活跃,以便你可以登录、点击、滚动并在身份验证后提取数据。
- ScrapeOps 处理代理选择和故障转移。 无需手动为每个目标站点基准测试代理提供商,ScrapeOps 会为每个域选择性能最佳的代理,并在发生故障时切换到替代方案。它还增加了监控、调度和用于将 HTML 转换为结构化 JSON 的 Parser API。
在实践中,AdsCrawl 为你提供可靠的浏览器环境;ScrapeOps 为你提供可靠的网络路径,并在目标站点加强防御时提供安全网。两者结合减少了抓取器失败的两个最常见原因:从未渲染的 JavaScript 密集型页面,以及无声退化的代理池。
两个产品如何配合
有两种实用的集成模式。根据你需要浏览器渲染还是仅 HTTP 级抓取来选择。
模式 1:ScrapeOps 作为 AdsCrawl 请求的代理层
AdsCrawl 在其浏览器任务和云浏览器配置文件中接受自定义代理。你可以将 AdsCrawl 指向 ScrapeOps 代理端点,以便每个浏览器请求都通过 ScrapeOps 的聚合代理网络出口。这是动态站点的最强组合:AdsCrawl 在真实 Chromium 中渲染页面,ScrapeOps 提供轮换的住宅或移动出口。
模式 2:AdsCrawl 作为 ScrapeOps 驱动管道背后的渲染器
如果你的管道已经使用 ScrapeOps 进行代理管理和监控,只将困难的页面——SPA、需要身份验证的仪表板、受机器人检查保护的页面——路由到 AdsCrawl。ScrapeOps 继续为简单页面管理代理和调度,而 AdsCrawl 处理其余页面的渲染和 CDP 自动化。这使成本可预测,因为你只在确实需要渲染的地方花费浏览器积分。
一个有用的经验法则:如果数据存在于原始 HTML 响应中,代理级抓取就足够了。如果数据仅在 JavaScript 执行后出现,或需要登录,则发送到 AdsCrawl。
设置:先决条件
First viewport screenshot of scrapeops.io.
scrapeops.io 的首屏截图。
在将两者连接之前,请确认你有:
- 一个 AdsCrawl 账户,并从仪表板获取 API 密钥。新账户注册时获得 500 积分,免费层包括轮换住宅代理。
- 一个 ScrapeOps 账户,并获取 API 密钥。免费层包括 1,000 次请求和 100 MB 带宽。
- 一个用于密钥的服务器端环境——切勿将任一密钥嵌入客户端代码。
- 一个客户端库:cURL、Python
requests、Node.jsfetch,或用于 CDP 工作流的 Playwright/Puppeteer。
分步指南:使用 AdsCrawl 通过 ScrapeOps 代理渲染动态页面
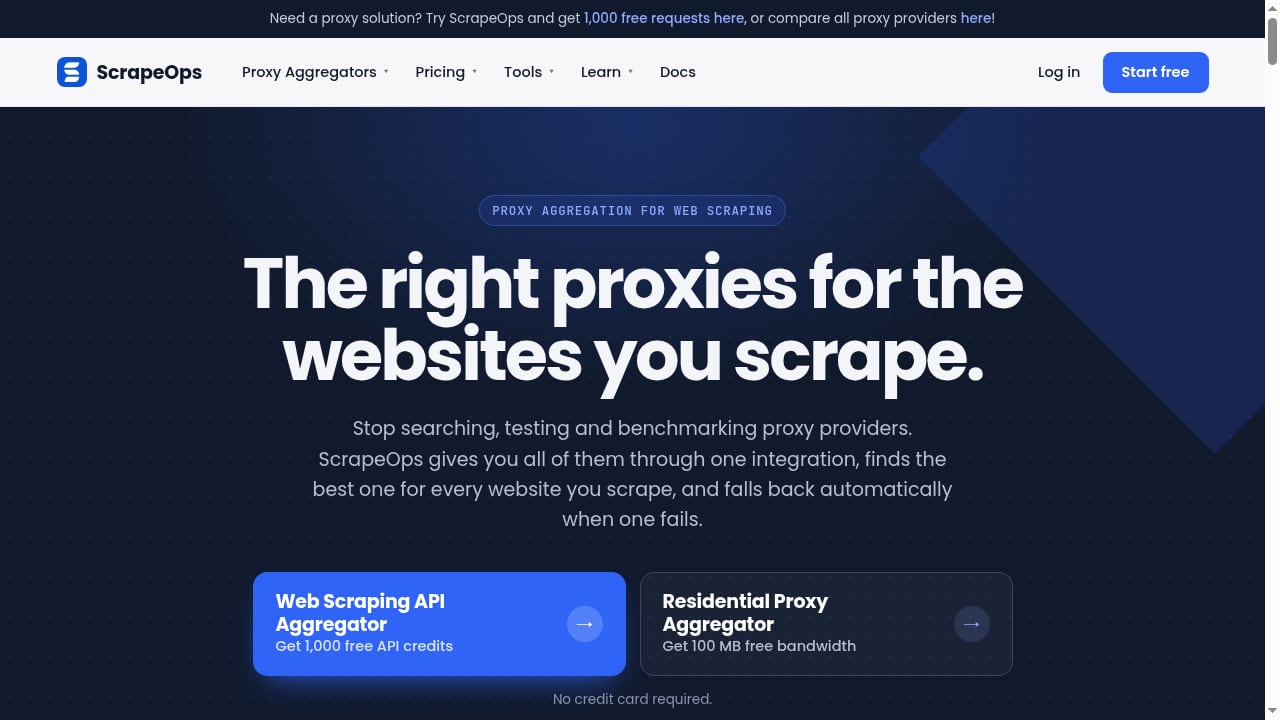
First viewport screenshot of scrapeops.io.
scrapeops.io 的首屏截图。
步骤 1:发出你的第一个 AdsCrawl 请求
从同步 HTML 端点开始。它使用安全的浏览器默认值,避免管理有状态会话,是确认密钥有效的最快方式。
export ADSCRAWL_API_KEY="your-api-key"

curl --fail-with-body -sS -X POST "https://api.adscrawl.net/html" \
  -H "content-type: application/json" \
  -H "x-api-key: $ADSCRAWL_API_KEY" \
  -d '{
    "url": "https://example.com/article",
    "contentMode": "markdown",
    "waitUntil": "domcontentloaded"
  }'
成功的响应会以你请求的格式返回渲染后的内容。如果你需要结构化字段而不是文档,请在同一端点系列上使用 CSS 选择器或拦截的网络响应。
步骤 2:为 AdsCrawl 配置 ScrapeOps 代理
在你的 AdsCrawl 请求或云浏览器配置文件中,将 ScrapeOps 代理作为自定义代理提供。确切的代理主机和端口来自你的 ScrapeOps 仪表板;模式是带有 ScrapeOps 凭据的标准 HTTP 或 SOCKS 代理。配置后,AdsCrawl 的 Chromium 流量通过 ScrapeOps 的聚合器出口,该聚合器为目标域选择性能最佳的提供商。
记住两点:
- 会话一致性。 如果工作流需要在多个请求中使用相同的 IP(例如,多步骤结账或分页仪表板),请使用粘性会话选项,而不是在每个请求上轮换。
- 地理定位。 两个平台都支持国家级路由。在一个地方设置国家——理想情况下是 ScrapeOps——以避免代理层和浏览器配置文件之间的地理规则冲突。
步骤 3:为多步骤流程添加 CDP 会话
当页面需要交互时——登录、点击“加载更多”或滚动无限信息流——从同步 HTML 端点切换到远程 CDP 会话。AdsCrawl 返回一个会话 URL,你可以通过 Chrome DevTools Protocol 使用 Playwright 或 Puppeteer 连接。
import requests
from playwright.sync_api import sync_playwright

resp = requests.post(
    "https://api.adscrawl.net/browser",
    headers={"x-api-key": "your-api-key"},
    json={"url": "https://example.com/login"},
)
ws_url = resp.json()["ws_endpoint"]

with sync_playwright() as p:
    browser = p.chromium.connect_over_cdp(ws_url)
    page = browser.contexts[0].pages[0]
    page.fill("#email", "user@example.com")
    page.fill("#password", "secret")
    page.click("button[type=submit]")
    page.wait_for_load_state("networkidle")
    html = page.content()
    browser.close()
由于浏览器在命令之间保持活跃,你只需验证一次,并在后续提取中重用 cookie。AdsCrawl 管理浏览器生命周期;ScrapeOps 管理其下的网络路径。
步骤 4:添加监控和回退
ScrapeOps 监控跟踪抓取器健康状况和性能,以便你可以看到目标站点何时开始失败以及哪个代理提供商负责。将其与 AdsCrawl 自身的错误信号——HTTP 429 响应和会话失败——配对,并在客户端实现指数退避。围绕 AdsCrawl 调用的简单重试包装器,加上 ScrapeOps 在其下处理代理故障转移,覆盖了大多数生产故障模式。
步骤 5:将 HTML 转换为结构化 JSON
一旦 AdsCrawl 返回渲染后的 HTML,你有两种解析选项。使用你偏好的库自行解析,或将其发送到 ScrapeOps 的 Parser API 将 HTML 转换为结构化 JSON。后者在你希望跨多个站点获得一致的输出模式而无需为每个目标维护解析器时很有用。
实际示例:价格监控管道
考虑一个零售商,其产品页面通过 JavaScript 渲染价格,并偶尔提供机器人挑战。
- 调度 使用 ScrapeOps 的 Server Manager & Scheduler 调度任务。
- 渲染 使用 AdsCrawl 的 HTML 端点渲染每个产品 URL,请求 Markdown 或结构化 JSON。
- 路由 将 AdsCrawl 流量通过 ScrapeOps 代理聚合器路由,以便被阻止的请求自动在不同提供商上重试。
- 解析 将渲染输出解析为价格字段,可以使用 AdsCrawl 中的 CSS 选择器或 ScrapeOps Parser API。
- 监控 在 ScrapeOps 中监控成功率,并在某个域的失败率超过阈值时发出警报。
此管道解决了两个经典故障点——未渲染的内容和代理耗尽——而无需你管理浏览器集群或基准测试代理供应商。
何时只使用其中一个
scrapeops.io 的首屏截图。
这种组合很强大,但并非总是必要。
| 场景 | 推荐方法 |
|---|---|
| 静态 HTML 页面,高流量,低成本敏感度 | 仅使用 ScrapeOps 代理层 |
| JavaScript 密集型 SPA、截图、身份验证会话 | 单独使用 AdsCrawl 或配合 ScrapeOps 代理 |
| 简单和困难目标的混合组合 | 困难页面用 AdsCrawl,路由和调度用 ScrapeOps |
| 严格的每请求预算且机器人防御不可预测 | ScrapeOps 聚合加上仅在需要时使用 AdsCrawl 进行渲染 |
如果你仍在评估浏览器自动化提供商,我们的 AdsCrawl vs ScraperAPI 比较解释了真实浏览器会话与简单抓取 API 的区别。有关渲染、代理和 CDP 权衡的更广泛视角,请参阅 AdsCrawl vs Bright Data vs Lightpanda。
常见陷阱及如何避免
- 双重代理轮换。 如果 AdsCrawl 和 ScrapeOps 都轮换 IP,依赖会话的流程会中断。选择一个层来控制轮换。
- 地理设置不匹配。 在 ScrapeOps 中设置目标国家,并保持 AdsCrawl 的国家选项未设置,反之亦然——不要两者都设置。
- 忽略加载状态。 使用与页面行为匹配的
waitUntil值;domcontentloaded很快,但可能错过延迟渲染的数据。 - 跳过重试。 始终使用退避处理 429 和瞬态 5xx 响应,然后再升级到不同的代理路由。
- 过度使用浏览器会话。 每个 AdsCrawl 请求都会消耗积分;只路由真正需要渲染的页面。
对于构建生产自动化的团队,监控使用情况和成功率与抓取逻辑本身同样重要。我们的 浏览器自动化使用分析 指南涵盖了如何捕获事件并衡量云浏览器作业的可靠性。
相关阅读
- AdsCrawl vs Context.dev vs Spider:哪个适合? - 比较 AdsCrawl、Context.dev 和 Spider 在浏览器自动化、AI 数据提取和抓取方面的表现。了解哪个工具适合你的工作流。
- 浏览器自动化与网页抓取:无代码 vs 代码审查 - 基于证据的浏览器自动化和网页抓取工具审查,比较无代码和代码方法。涵盖理想用户、用例、优势、限制、定价、设置和决策标准。
来源与进一步阅读
- AdsCrawl 文档 | AdsCrawl - 使用 AdsCrawl 的渲染内容 API、结构化提取、远程 CDP 会话和实时控制构建浏览器工作流。
- AdsCrawl:用于网页抓取的浏览器自动化 API - AdsCrawl - AdsCrawl 是一个面向开发者的浏览器自动化 API,需要通过住宅代理获取渲染后的 HTML、结构化数据、截图和完整 CDP 会话。
- 如何使用 AdsCrawl:完整 API 教程 - 学习如何使用 AdsCrawl 的浏览器自动化 API 捕获截图、提取 HTML/Markdown 并控制远程 CDP 会话。包含代码示例的分步设置。
常见问题
First viewport screenshot of scrapeops.io.
AdsCrawl 已经包含代理,为什么还要添加 ScrapeOps?
AdsCrawl 包含轮换住宅代理并支持自定义代理。ScrapeOps 增加了自动提供商选择、跨 20 多家提供商的故障转移和监控。如果你抓取少量站点,AdsCrawl 的内置代理可能就足够了。如果你抓取许多具有不同防御的域,ScrapeOps 减少了手动代理管理。
我可以将 ScrapeOps 与 AdsCrawl 的远程 CDP 会话一起使用吗?
是的。在云浏览器配置文件或会话上配置 ScrapeOps 代理,然后通过 CDP 连接 Playwright 或 Puppeteer。浏览器流量通过 ScrapeOps 出口,同时你保持完整的 DevTools 控制。
哪个工具应该解析数据?
两者都可以。AdsCrawl 可以使用 CSS 选择器或拦截的网络响应返回结构化 JSON。ScrapeOps 的 Parser API 将 HTML 转换为具有一致模式的 JSON。根据你更喜欢在渲染时解析还是在下游解析来选择。
有没有免费的方法来测试这种组合?
有。AdsCrawl 注册时提供 500 积分和免费层,ScrapeOps 提供 1,000 次免费请求和 100 MB 带宽。这足以在承诺付费计划之前验证一个小型管道。
AI 代理工作流呢?
ScrapeOps 提供用于 AI 代理集成的 MCP Server 和生成抓取器代码的 AI Scraper Builder。AdsCrawl 的 Markdown 输出非常适合馈送给 LLM。将 AdsCrawl 的干净 Markdown 与 ScrapeOps 的代理工具相结合是 AI 数据收集的实用模式。
结论
AdsCrawl 和 ScrapeOps 解决了同一问题的不同部分。AdsCrawl 为你提供一个真实的云浏览器,可以渲染动态页面、维护身份验证会话并返回干净的输出。ScrapeOps 为你提供一个弹性代理层,为每个站点选择最佳提供商、自动故障转移并监控性能。结合使用,它们让你只将困难页面路由到浏览器渲染,而代理层吸收阻止和提供商中断——这种组合对于动态网站的生产抓取来说比任一工具单独使用都更可靠。
从小测试开始:通过 AdsCrawl 使用 ScrapeOps 代理渲染一个 JavaScript 密集型页面,确认输出,然后将模式扩展到你的完整目标列表。