如何使用 Firecrawl:浏览器自动化 API 指南
通过 AdsCrawl 学习如何使用 Firecrawl 风格的浏览器自动化:渲染 JavaScript 页面、提取结构化数据,并运行有状态的 Playwright 会话。
如何使用 Firecrawl:浏览器自动化 API 指南
如果你搜索过“如何使用 Firecrawl”,你很可能正试图将一个 JavaScript 密集型网站转化为干净、可用的数据,而不必维护一堆无头浏览器。同样的工作流模式适用于任何浏览器自动化 API,包括 AdsCrawl。本指南将向你展示如何利用 AdsCrawl 的同步端点和有状态远程 Chromium 会话,从单个 URL 构建可重复的提取管道。
浏览器自动化 API 的实际作用
First viewport screenshot of www.adscrawl.net.
www.adscrawl.net 的首屏截图。
浏览器自动化 API 在云端运行真实浏览器,并通过 HTTP 或远程调试协议将其暴露出来。你无需在本地机器上安装 Chromium、管理代理和修补反机器人漏洞,只需发送请求并接收渲染后的输出。
AdsCrawl 提供两个互补的接口:
- 同步端点,用于一次性任务:截图、渲染 HTML、Markdown 和 SPA 提取。
- 有状态远程 Chromium 会话,可连接 Playwright、Puppeteer 或原始 CDP 客户端,用于多步骤工作流。
这种划分很重要。简单提取应该是一次 API 调用。复杂流程——登录、分页、填写表单——则需要持久化的浏览器会话。
快速开始:你的第一个渲染请求
First viewport screenshot of www.adscrawl.net.
www.adscrawl.net 的首屏截图。
在编写代码之前,请创建一个 AdsCrawl 账户。新用户可获得 500 个免费积分,足以测试渲染、截图以及几个基于会话的工作流。
第 1 步:选择输出格式
AdsCrawl 支持 HTML、Markdown、JSON 和截图输出。根据数据的使用方来选择:
| 输出 | 最适合 |
|---|---|
| Markdown | LLM 上下文、RAG 管道、文档 |
| 渲染 HTML | 基于选择器的解析、归档 |
| JSON | 用于数据库或应用的结构化记录 |
| 截图 | 视觉 QA、监控、证据捕获 |
如果你要提供给 AI 代理,Markdown 通常是最干净的起点。如果你需要精确字段,使用模式进行 JSON 提取比脆弱的 CSS 选择器更可靠。
第 2 步:发送同步请求
最简单的模式是单次 HTTP 调用返回渲染内容。一个典型的请求在伪代码中如下所示:
import requests

response = requests.post(
    "https://api.adscrawl.com/v1/render",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    json={
        "url": "https://example.com/product/123",
        "format": "markdown"
    }
)

print(response.text)
将端点和负载替换为 AdsCrawl OpenAPI 规范中的确切值。该平台发布了 OpenAPI 规范和 AI 友好的 llms.txt 索引,以便编码代理无需猜测即可发现端点。
第 3 步:验证渲染输出
JavaScript 密集型页面通常对普通 HTTP 客户端返回空结果。在构建下游逻辑之前,请检查响应是否包含你期望的内容——价格、评论或表格行。如果输出为空,页面可能需要完整的浏览器会话,而不是简单的获取。
何时从端点转向远程会话
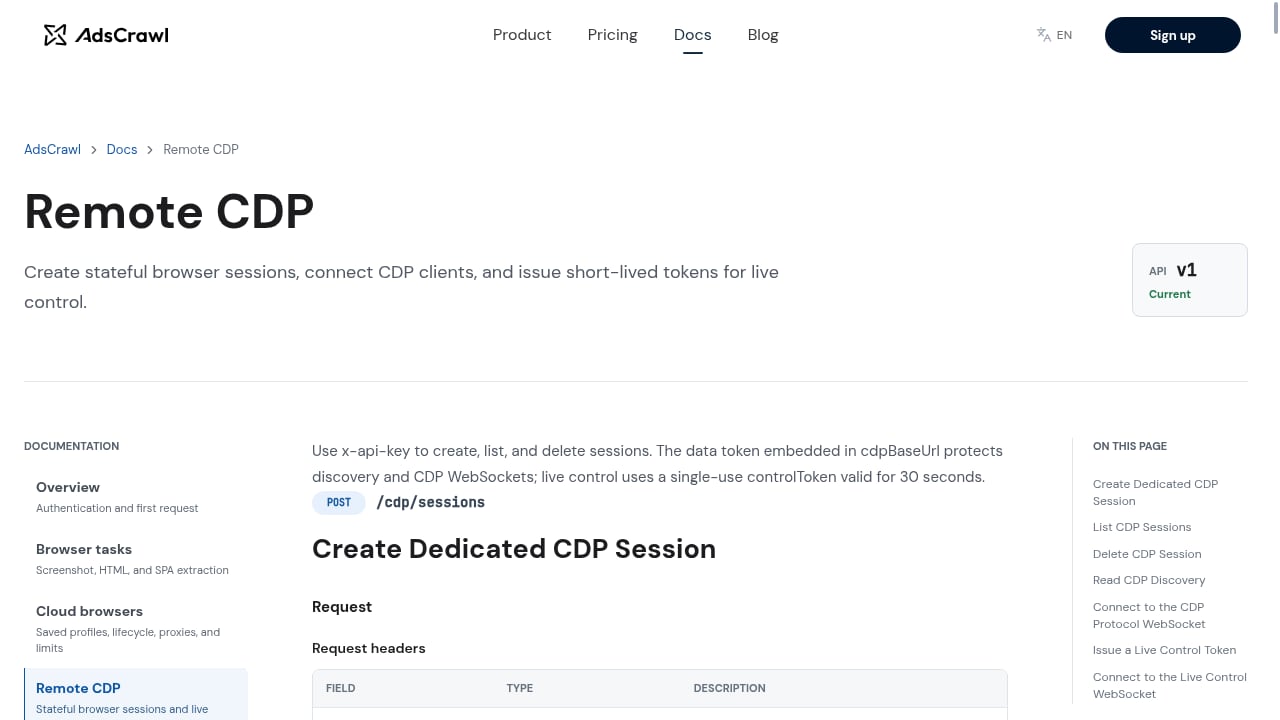
First viewport screenshot of www.adscrawl.net.
www.adscrawl.net 的首屏截图。
同步端点覆盖大多数提取任务。当你的工作流需要以下任何一项时,请转向有状态远程 Chromium 会话:
- 使用必须在请求之间保持的 cookie 或令牌进行身份验证。
- 通过点击、表单提交或无限滚动进行多页面导航。
- 自定义标头、User-Agent 轮换或区域特定路由。
- 通过查看器进行交互式调试。
AdsCrawl 允许你保存和启动具有生命周期管理、自定义代理和交互式查看器访问的云浏览器配置文件。这意味着你可以保持登录会话活跃,稍后重新连接,并避免在每次运行时重复登录流程。要深入了解其工作原理,请参阅浏览器自动化中的会话持久性:开发者指南。
连接 Playwright、Puppeteer 或 CDP
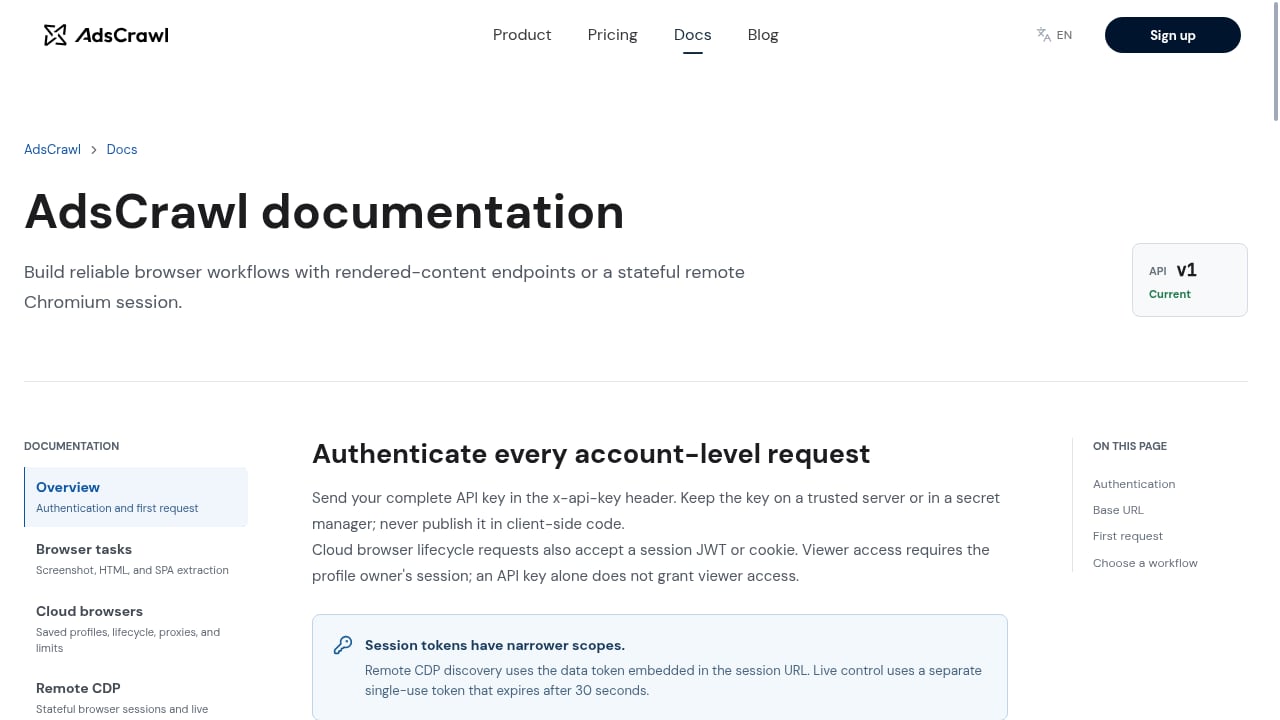
First viewport screenshot of www.adscrawl.net.
www.adscrawl.net 的首屏截图。
AdsCrawl 暴露可连接到标准客户端的远程 Chromium 会话。各库的模式相同:请求会话、获取 WebSocket 端点并连接。
Playwright 示例
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.connect_over_cdp("wss://your-session-endpoint")
    page = browser.new_page()
    page.goto("https://example.com/dashboard")
    page.fill("#search", "wireless headphones")
    page.click("button[type=submit]")
    page.wait_for_selector(".results")
    print(page.inner_text(".results"))
    browser.close()
Puppeteer 示例
const puppeteer = require('puppeteer-core');

(async () => {
  const browser = await puppeteer.connect({
    browserWSEndpoint: 'wss://your-session-endpoint'
  });
  const page = await browser.newPage();
  await page.goto('https://example.com/dashboard');
  await page.type('#search', 'wireless headphones');
  await page.click('button[type=submit]');
  await page.waitForSelector('.results');
  console.log(await page.$eval('.results', el => el.innerText));
  await browser.close();
})();
原始 CDP 客户端的工作方式相同:连接到会话端点并直接发出协议命令。当你需要对网络拦截或性能指标进行细粒度控制时,这很有用。
处理反机器人保护和区域特定内容
许多网站会阻止看起来像自动化的请求。AdsCrawl 包含托管浏览器身份、随机 User-Agent、可信代理、住宅代理路由和动态区域路由。请有意识地使用这些功能:
- 将区域与内容匹配。 如果你需要德国店面的价格,请通过德国代理路由。
- 按会话轮换身份,而不是按请求。 在一个会话内频繁更改可能会触发怀疑。
- 遵守网站条款和 robots.txt。 自动化能力并不能免除法律或道德义务。
如果你正在比较浏览器基础设施选项,2026 年面向 AI 代理的十大云浏览器基础设施综述涵盖了定价、并发和隐身权衡。
可靠地提取结构化数据
自由文本提取很容易;结构化提取才是管道容易断裂的地方。两种方法效果良好:
- 模式优先提取: 定义你需要的字段(标题、价格、评分、可用性),并根据该模式验证每个响应。
- 基于选择器的解析: 使用渲染后的 HTML 和稳定的选择器,并在 DOM 变化时提供回退方案。
AdsCrawl 的 JSON 输出和渲染 HTML 端点支持这两种方法。对于电子商务工作流,如何将 AdsCrawl 与 Price API 结合用于数据驱动的电子商务指南展示了如何将渲染与价格丰富相结合。
实用工作流:竞争对手价格监控
以下是你可以在一个下午构建的现实管道:
- 将目标产品 URL 存储在数据库中。
- 对于每个 URL,调用同步渲染端点,输出 Markdown 或 JSON。
- 解析价格和可用性字段。
- 将结果写入时间序列表。
- 当价格低于阈值时发出警报。
从 10 个 URL 开始,以验证选择器和输出质量。然后使用并发请求扩展到数百或数千个,并在需要时对需要登录或区域选择的网站使用有状态会话。
常见错误及如何避免
- 在检查之前抓取。 先在开发者工具中打开页面,确认哪些元素是客户端渲染的。
- 忽略速率限制。 批量请求并添加退避逻辑。
- 硬编码选择器。 添加回退方案并监控空结果。
- 跳过验证。 拒绝未通过模式检查的记录,而不是存储坏数据。
- 忘记会话清理。 完成后关闭远程会话,以避免不必要的积分消耗。
相关阅读
- 2026 年十大网页抓取浏览器扩展 - 2026 年十大网页抓取浏览器扩展的独立排名,包含定价、限制、分页以及何时转向抓取 API 的证据。
- 如何将 AdsCrawl 与 Cloudflare 开发者文档结合使用 - 了解如何将 AdsCrawl 的浏览器自动化 API 与 Cloudflare 开发者文档配对,以抓取渲染后的开发者文档并构建可靠的 AI 上下文管道。
- AdsCrawl vs ScreenshotEngine vs Screenshotlayer:2026 指南 - 比较 AdsCrawl、ScreenshotEngine 和 Screenshotlayer 在截图、浏览器控制和数据提取方面的表现。为你的工作流找到合适的工具。
来源与进一步阅读
- 面向初学者的网页抓取:分步指南 - 在本初学者指南中学习如何使用 Python 从网站收集数据。
- Firecrawl 完整初学者课程 | 让我们抓取一切 - 👉 加入我的 Skool 社区:https://www.skool.com/the-ai-agent/about🤖 一对一辅导支持:https://calendly.com/tylerreedytlearning/strategy-call🙇🏻 Wh...
- 简介 | Firecrawl - 面向 AI 代理的上下文 API。搜索网络、抓取任何页面,并通过一个 API 与之交互。
常见问题
使用 AdsCrawl 需要安装浏览器吗?
不需要。AdsCrawl 在云端运行 Chromium。你可以使用同步端点而无需任何本地浏览器,或将 Playwright、Puppeteer 或 CDP 客户端连接到远程会话。
同步端点和远程会话有什么区别?
同步端点处理单个请求并立即返回输出。远程会话保持浏览器活跃,以便你可以执行多个操作、保留 cookie 并跨页面导航。
AdsCrawl 能处理 JavaScript 密集的单页应用吗?
可以。AdsCrawl 包含专为客户端构建内容的页面设计的 SPA 提取和渲染 HTML 输出。
我能获得多少免费积分?
新账户在注册时获得 500 个免费积分。付费计划包括 Free、Hobby、Starter 和 Pro 层级,采用基于积分的订阅。
在哪里可以找到 API 参考?
AdsCrawl 发布包含 OpenAPI 规范和 llms.txt 索引的文档,AI 编码代理可以直接阅读。
结论
用好浏览器自动化 API 的关键在于为每项工作选择合适的接口:同步端点用于快速提取,远程 Chromium 会话用于有状态工作流,结构化输出格式用于可靠的下游处理。AdsCrawl 在一个平台中为你提供所有三种能力,并具备托管身份、代理路由和区域控制,以处理那些抵抗简单工具的网站。从免费积分开始,端到端验证一个工作流,然后扩展。