
2026年十大无代码网页抓取软件产品
比较2026年十大无代码网页抓取工具在设置、动态网站支持、AI提取、扩展性和定价方面的表现,为你的工作流程找到最佳选择。
2026年十大无代码网页抓取软件产品
无代码网页抓取软件早已超越了简单的点击选择器。在2026年,最强大的工具将可视化构建器与AI辅助字段检测、定时云端运行以及内置代理或反封锁层相结合。这使得无需编写代码即可收集数据变得比以往更容易,但也让购买决策更加困难,因为两个在定价页面上看起来相似的工具,在JavaScript密集型网站上的表现可能截然不同。
本评测对十款真正属于无代码网页抓取类别的产品进行了排名。每个条目都根据透明的标准进行评估,证据来自供应商文档、公开定价和独立比较研究。目标不是选出一个通用赢家,而是帮助你根据实际工作流程匹配工具。
我们如何评估这些无代码抓取工具
First viewport screenshot of www.webharvy.com.
以下每款产品都根据相同的六个维度进行评判:
- 设置模式: 它是桌面应用、浏览器扩展、云平台还是AI提示界面?首次抓取需要多长时间?
- 动态网站支持: 它是否渲染JavaScript、处理分页和无限滚动,并在单页应用上工作?
- 提取控制: 你可以检查和编辑选择器,还是依赖不透明的AI输出?
- 可重复性和调度: 任务能否按计划运行,并在网站变化时自我修复?
- 扩展和访问基础设施: 代理、CAPTCHA处理和并发是包含在内还是单独计费?
- 定价透明度: 积分、行数和页面加载的定价是否清晰,是否有可用的免费套餐?
定价根据供应商页面和2026年发布的比较研究进行了核对,包括Web Scraper对AI抓取工具的比较和Firecrawl的网页抓取工具汇总。价格经常变化,因此请将数字视为方向性参考,并在承诺前确认当前配额。
2026年十大无代码网页抓取产品
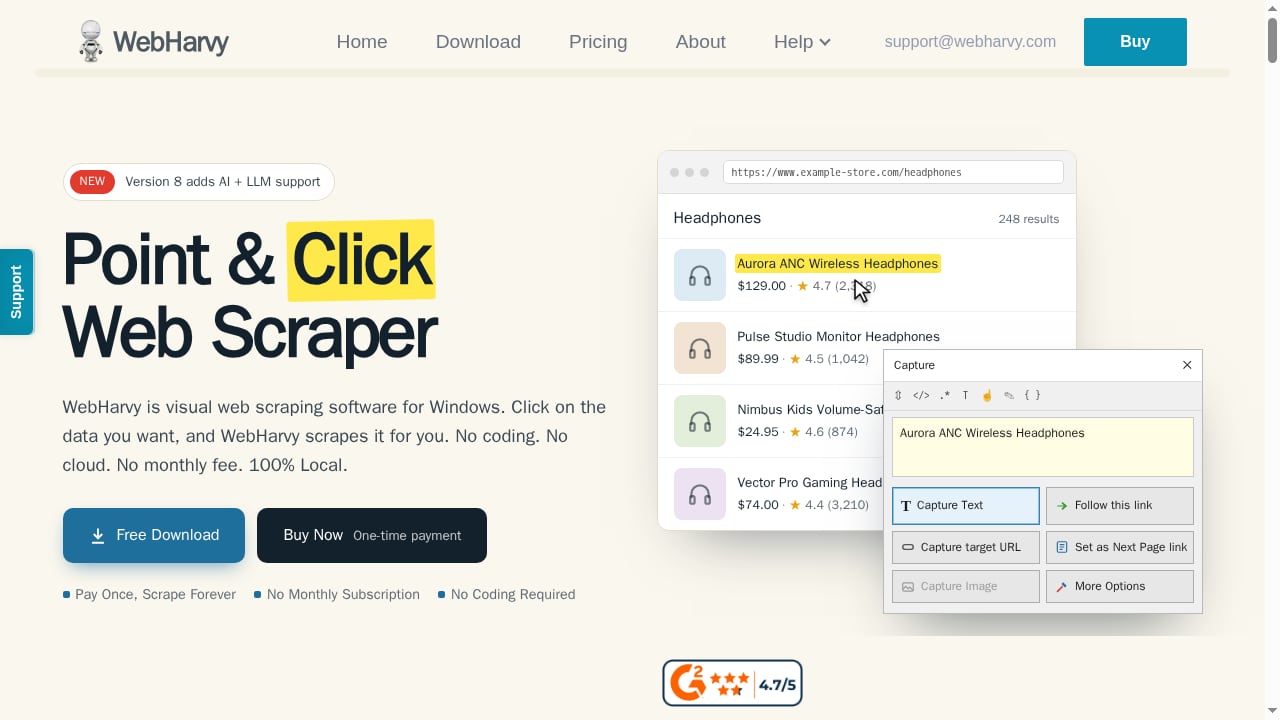
First viewport screenshot of www.webharvy.com.
1. WebHarvy — 最适合一次性购买和本地控制
WebHarvy是一款围绕点击式界面构建的可视化网页抓取工具:你在实时页面上点击想要的数据,工具会生成提取模式。它在本地运行,这意味着你的抓取任务和数据保留在你自己的机器上,并且它支持云或本地AI提供商和LLM进行辅助提取。
其决定性的商业差异在于定价模式。WebHarvy以一次性许可而非月度订阅的方式出售,这对运行重复但中等量级任务并希望避免累积云费用的团队很有吸引力。权衡之处在于,扩展、代理轮换和调度更多是你自己的责任,而不是托管云平台的责任。
最适合: 注重预算的分析师、研究人员和小团队,他们想要一个无需订阅的永久可视化抓取工具。
2. Octoparse — 最适合详细的视觉工作流程
Octoparse是最成熟的无代码平台之一,提供带有数百个网站模板的桌面工作流构建器,以及一个可以起草提取步骤的AI助手。它处理循环、分页、无限滚动、下拉菜单和悬停交互,并可以将完成的任务推送到24/7云执行,具有IP轮换和CAPTCHA处理功能。
界面功能强大但繁重。简单任务可能感觉过度设计,而积分系统(任务、行数、云运行和并发都分别限制)需要阅读后才能预测成本。独立比较一致将Octoparse列为非技术用户需要结构化、可重复爬取时最强大的可视化构建器之一。
最适合: 想要完整桌面工作流构建器并愿意学习其模型以换取精细控制的用户。
3. Browse AI — 最适合简单的监控和变更提醒
Browse AI采用记录和回放的方法:你通过演示想要的数据来训练云机器人,然后它按计划运行,并可以在值变化时提醒你。这使得它特别适合价格监控、竞争对手跟踪和轻量级潜在客户列表构建。
由于机器人从示例而非显式选择器学习,控制不如桌面构建器精细。积分消耗还受到行数、详情页、截图和网站类型的影响,因此大量详情页爬取可能比标题计划所暗示的更快耗尽配额。不过,对于简单的监控任务,设置是此列表中最快的之一。
最适合: 需要定时监控而非深度自定义爬取的营销人员和运营团队。
4. Thunderbit — 最适合快速的浏览器到电子表格提取
Thunderbit是一个浏览器扩展,可以建议字段并将页面数据结构化到电子表格或API模式中。它专为速度设计:打开页面,让工具提议列,然后导出。这使其非常适合一次性研究、列表构建和快速竞争检查。
它不太适合深度建模的爬取。扩展和API分别计费,API对其Distill和Extract模式使用不同的单位成本,因此从临时提取转向生产量的团队应仔细建模成本。作为无代码抓取的快速、低摩擦入口点,它很难被超越。
最适合: 希望在几分钟内将数据放入电子表格而非配置管道的分析师。
5. Bright Data Scraper Studio — 最适合企业访问基础设施
Bright Data的Scraper Studio从自然语言提示生成抓取代码,并在具有内置代理、CAPTCHA解决和自动反封锁的云基础设施上运行。自我修复能力在目标网站变化时重构抓取工具,这解决了抓取中最大的维护成本。
该平台由非常大的住宅代理网络支持,并围绕合规性和正常运行时间定位自己。这种基础设施在大规模下确实有价值,但对于小任务可能过度且昂贵。Bright Data按成功页面加载发布按需付费定价,独立评论在信任平台上对其评价很高。
最适合: 需要在一个托管堆栈中实现反封锁、代理和自我修复抓取工具的企业。
6. Apify — 最适合现成抓取工具的市场
Apify是一个自动化云,拥有大量预构建抓取工具(称为Actors)的市场,以及一个支持自然语言提取和代理爬取模式的AI网页抓取工具。对于无代码用户,市场是吸引力所在:你可以为热门网站运行维护良好的抓取工具而无需构建任何东西。
成本是模块化的。Actor使用、计算、存储、数据传输和代理分别计费,因此总支出可能超过单个Actor的标价。该平台提供少量月度使用配额作为起点。如果你愿意组装组件,这是这里最灵活的选项。
最适合: 希望从现有抓取工具开始并发展为自定义自动化的团队。
7. Kadoa — 最适合受治理的自我维护管道
Kadoa专注于代理生成的确定性管道:AI构建提取逻辑、监控它,并在网站变化时修复它,而管道本身以确定性方式运行以确保可审计性。这种组合直接面向需要可靠性和治理而非临时拉取的金融、市场情报和企业数据团队。
它不是最便宜或最简单的入口点,其定位比通用抓取工具更窄。但对于将抓取数据视为生产输入的组织,自我维护和监督功能证明了溢价的合理性。
最适合: 需要受监控、可审计数据管道的企业和金融团队。
8. Oxylabs OxyCopilot — 最适合AI辅助解析器生成
OxyCopilot是Oxylabs Web Scraper API内的AI助手,从纯英文提示生成解析模板和浏览器指令。它分析复杂的HTML并生成可重用的解析器,这减少了通常伴随基于API的抓取的手动选择器工作。
无代码界面是提示界面,而不是可视化页面构建器,因此它适合习惯在API仪表板内工作的用户。定价遵循Web Scraper API使用量,并随网站复杂性而变化。Oxylabs在代理基础设施方面的更广泛声誉在目标受保护时是一个有意义的优势。
最适合: 希望获得由成熟抓取API和代理网络支持的AI生成解析器的用户。
9. Zyte AI Web Scraping — 最适合大规模电子商务数据
Zyte的AI网页抓取结合了自动爬取、反封锁和基于ML的解析,构建在Scrapy框架上。它针对产品和电子商务数据进行了优化,自动解析可适应网站变化,并为希望控制的团队提供可选的手动覆盖。
Zyte报告内部测试显示设置和维护时间大幅减少,其按需付费定价每千次请求起步较低,尽管费率因网站层级而异。提示驱动的提取模式使其无需深度编码即可使用,但平台假设一定的技术舒适度。
最适合: 需要量级、反封锁和自适应解析的电子商务和零售数据团队。
10. Web Scraper (webscraper.io) — 最适合免费的本地起点
Web Scraper是一个基于浏览器扩展的可视化抓取工具,具有可编辑的站点地图模型和AI辅助的站点地图创建。其突出功能是无限制的本地抓取模式,不花费任何费用,并提供付费云层用于定时执行和扩展。
这个免费的本地层使其成为学习无代码抓取的最低风险方式。站点地图模型有学习曲线,高级工作流需要理解选择器如何嵌套,但检查和纠正提取逻辑的能力相对于不透明的纯AI工具是一个真正的优势。云计划根据层级按URL积分或并发抓取工具容量计费。
最适合: 希望在支付云容量之前进行无限制本地抓取的初学者和预算用户。
快速比较:哪种无代码抓取工具适合你的工作?
First viewport screenshot of www.webharvy.com.
| 如果你的优先事项是… | 从…开始 | 为什么 |
|---|---|---|
| 一次性成本、本地数据控制 | WebHarvy | 一次性许可,点击式界面 |
| 详细的视觉工作流程 | Octoparse | 带有模板的深度桌面构建器 |
| 定时监控提醒 | Browse AI | 记录和回放云机器人 |
| 快速电子表格导出 | Thunderbit | 带有建议字段的扩展 |
| 大规模企业反封锁 | Bright Data Scraper Studio | 代理、CAPTCHA解决、自我修复 |
| 现成抓取工具 | Apify | 大型Actor市场 |
| 受治理的生产管道 | Kadoa | 自我维护的确定性管道 |
| API上的AI解析器 | Oxylabs OxyCopilot | 提示到解析器生成 |
| 电子商务量级 | Zyte | 自适应解析和反封锁 |
| 免费的起点 | Web Scraper | 无限制本地扩展 |
无代码的终点和浏览器自动化的起点
当目标网站是公开的、结构合理且容忍自动访问时,无代码抓取工具非常出色。当网站需要认证会话、大量交互或可视化构建器无法表达的自定义导航逻辑时,它们变得脆弱。
此时,团队通常会转向浏览器自动化API,并使用Playwright、Puppeteer或任何CDP客户端驱动真实的云浏览器。AdsCrawl是相邻类别的一个例子:一个托管的云Chromium环境,具有住宅代理路由和用于HTML、Markdown、JSON和截图的同步任务。它不是无代码抓取工具,也不属于此排名,但当无代码任务超出其构建器能力时,它是一个明智的下一步。如果你正在权衡这种过渡,AdsCrawl vs Bright Data vs Lightpanda的比较并排涵盖了渲染、代理、CDP控制和定价。
一种实用的混合模式很常见:使用无代码工具进行发现和简单字段提取,然后将困难页面交给浏览器API。同时跨浏览器测试抓取工具的团队可以将云自动化与设备测试相结合,如如何使用AdsCrawl与BrowserStack中所述。
购买无代码抓取工具时的常见陷阱
- 比较标价而非单位。 积分、行、页面加载和计算秒不可互换。将每个计划转换为每1,000页的大致成本,以适应你自己的工作量。
- 假设AI消除了维护。 AI有助于识别字段和修复损坏,但导航、验证和网站变化仍需要监督。
- 忽略JavaScript渲染。 许多网站现在在客户端渲染内容。在购买前确认工具执行JavaScript。
- 忘记代理和反封锁成本。 这些通常是单独的项目,在受保护的网站上可能主导账单。
- 跳过试用。 每个严肃的供应商都提供免费层或试用。在承诺前测试一个有代表性的网站。
相关阅读
- AdsCrawl vs ScreenshotOne:浏览器API还是截图API? - 比较AdsCrawl的完整浏览器自动化API与ScreenshotOne的截图聚焦API。看看哪个适合你的抓取、AI代理或视觉捕获工作流程。
- Olostep评测:2026年面向AI代理的Web数据API - 基于证据的Olostep评测,涵盖其搜索、抓取、爬取和监控API、定价信号、设置、理想用户以及AI团队的局限性。
来源和进一步阅读
First viewport screenshot of www.webharvy.com.
- 2026年最佳无代码网页抓取工具:15款工具比较 - 比较2026年排名前15的无代码网页抓取工具,包括AI驱动的工具。查看功能、定价、评论和免费试用比较,以帮助你选择最佳抓取工具。
常见问题
2026年最好的无代码网页抓取软件是什么?
没有单一的最佳工具。WebHarvy适合偏好一次性许可的买家,Octoparse适合详细的视觉工作流程,Browse AI适合监控,Bright Data Scraper Studio适合企业级反封锁。根据你的网站复杂性和量级匹配工具。
无代码抓取工具在JavaScript密集型网站上可靠吗?
许多是可靠的,但支持程度不同。Octoparse、Bright Data和Zyte等云平台渲染JavaScript并处理动态内容;更简单的扩展可能只捕获页面源代码中已有的内容。始终在真实目标页面上测试。
我可以完全不用编码进行抓取吗?
是的,对于大多数公共网站。可视化构建器和AI提示界面涵盖字段选择、分页和调度。当你需要认证会话、自定义交互逻辑或非常高的并发时,编码变得有用。
无代码网页抓取软件的费用是多少?
入门计划通常从免费层到每月约20-70美元不等,企业和大量计划可达数百美元。成本在很大程度上取决于积分乘数、代理使用以及是否包含云执行。
何时应从无代码抓取工具转向浏览器自动化API?
当你的任务需要登录、多步交互或可视化构建器无法表达的自定义导航时,或者当维护开销超过订阅成本时,就转向。托管浏览器API给你完全控制,代价是编写自动化代码。
结论
2026年的无代码抓取市场奖励特异性。如果你想要一个无需订阅的永久本地工具,WebHarvy是明确的选择。如果你需要深度视觉工作流程,Octoparse可以满足。对于监控、电子表格速度、企业反封锁、市场抓取工具、受治理管道、AI解析器、电子商务量级或免费起点,上面的排名每次都指向不同的领导者。
从匹配你主要工作的工具的免费层开始,在一个真实目标网站上测试,并在扩展前计算每1,000页的成本。并记住边界:无代码工具处理大多数公共网站提取,而当抓取真正变得困难时,浏览器自动化API接管。