
AdsCrawl vs Scrapy vs Thunderbit:2026 年哪款爬虫工具胜出?
对比 2026 年 AdsCrawl、Scrapy 和 Thunderbit 的网页抓取能力,了解哪款工具更适合动态网站、Python 流水线或无代码提取。
AdsCrawl vs Scrapy vs Thunderbit:2026 年哪款爬虫工具胜出?
在 2026 年选择网页抓取工具,首先要回答一个问题:谁在干活——你的代码、AI 智能体,还是托管云浏览器?Scrapy 让 Python 开发者拥有完全控制权。Thunderbit 完全免代码。AdsCrawl 居中,提供托管的云 Chromium 浏览器,你现有的 Playwright、Puppeteer 或 CDP 脚本可以直接驱动它。
这篇对比将拆解每款工具真正擅长的地方、遇到的困难,以及哪一款匹配你团队的技能和工作负载。
快速对比:AdsCrawl、Scrapy 和 Thunderbit
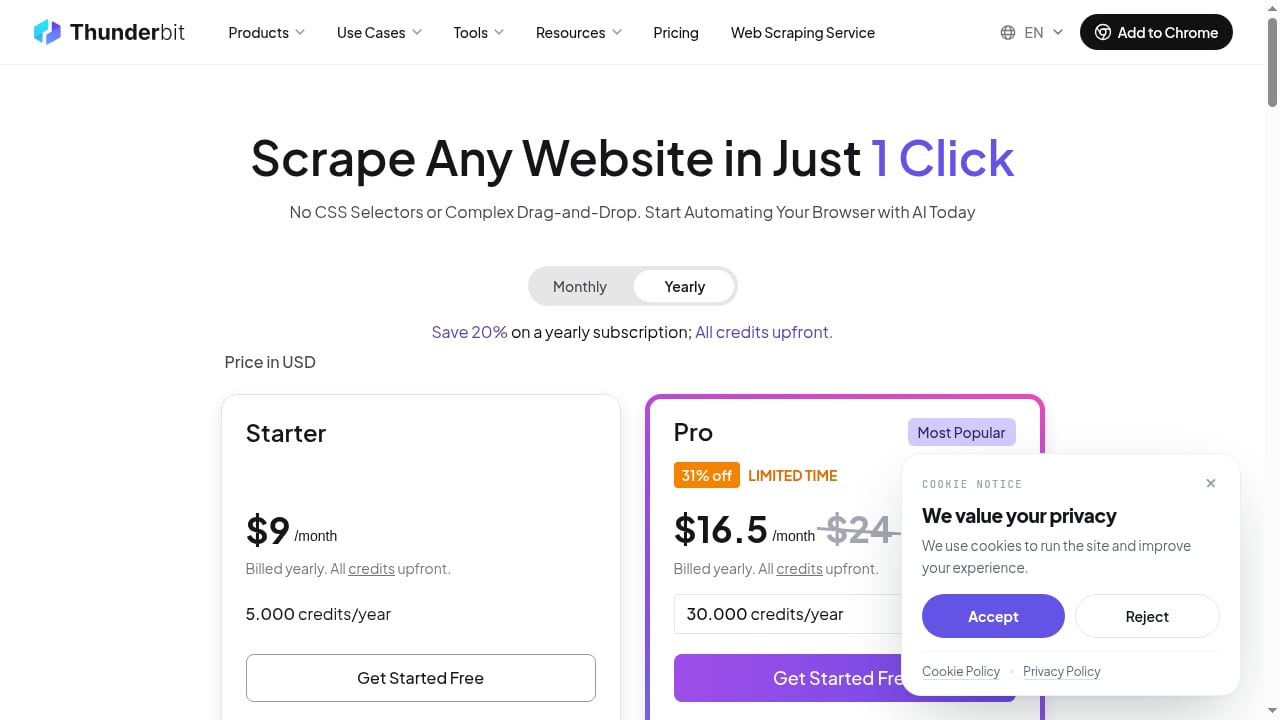
First viewport screenshot of Pricing Plans | Thunderbit.
Scrapy 知识库首屏截图 | Scrapy。
| 维度 | AdsCrawl | Scrapy | Thunderbit |
|---|---|---|---|
| 它是什么 | 托管云浏览器 + 浏览器自动化 API | 开源 Python 爬取框架 | 智能体无代码网页爬虫 |
| 设置成本 | API 密钥 + HTTP 请求或 CDP 连接 | Python 环境、爬虫代码、选择器 | 浏览器扩展,一键操作 |
| JavaScript 渲染 | 原生支持(真实云 Chromium) | 需要 scrapy-playwright 或类似方案 | 基于你看到的已渲染页面工作 |
| 最佳用户 | 运行生产抓取、QA、监控的开发者 | 构建自定义爬取流水线的 Python 团队 | 需要快速获得电子表格的非技术团队 |
| 代理处理 | 内置住宅代理路由,100+ 轮换 IP | 手动中间件配置 | 在支持的页面上托管处理 |
| 输出格式 | HTML、Markdown、JSON、截图 | 通过流水线自定义编码 | Excel、Google Sheets、Airtable、Notion |
| 定价模式 | 基于积分,提供免费套餐 | 免费(开源)+ 基础设施成本 | 订阅/基于积分 |
Scrapy:开源 Python 强者
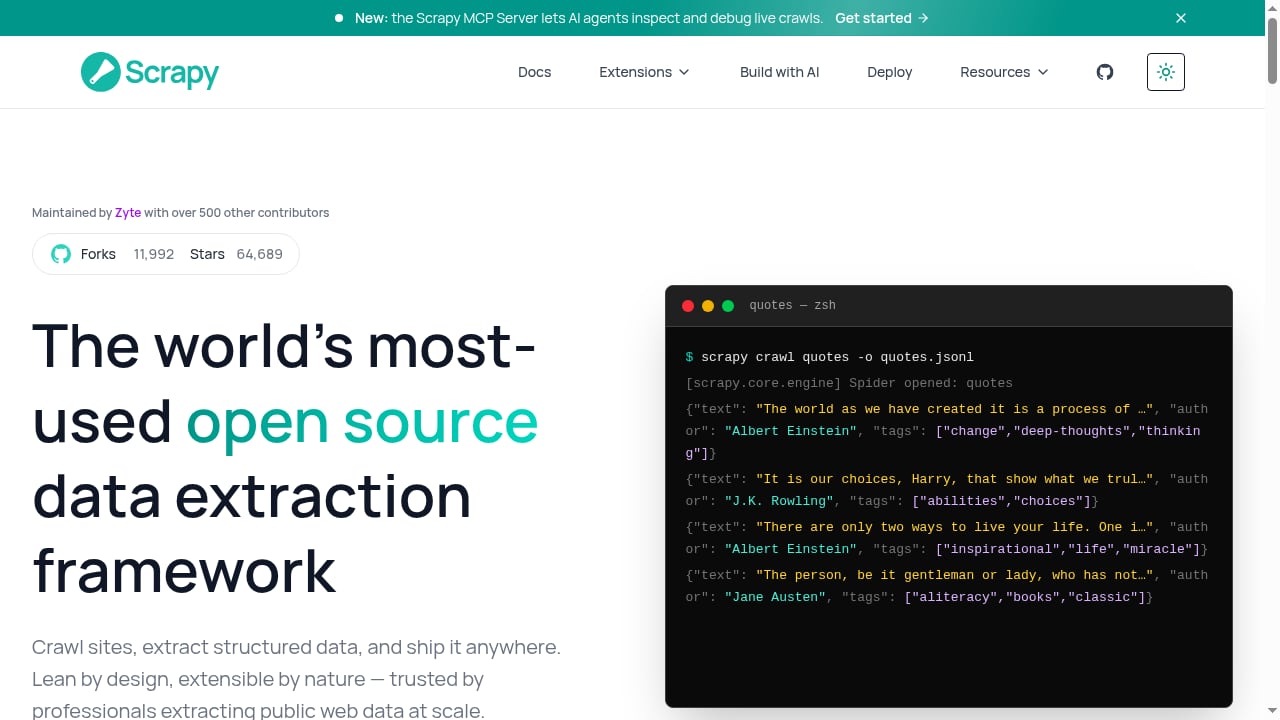
First viewport screenshot of Scrapy — open source web scraping framework for Python.
Scrapy 首屏截图 — 用于 Python 的开源网页抓取框架。
Scrapy 已经运行生产数据流水线超过十五年。它是用于网页抓取的主要开源 Python 框架——异步、可扩展、BSD 许可,拥有 500 多名贡献者和 64,000+ GitHub 星标。如果你需要以自定义逻辑爬取数百万页面,Scrapy 仍是基准。
Scrapy 的优势
- 完全控制每个请求。 你编写爬虫、定义 CSS 或 XPath 选择器,并构建用于清洗、验证和存储的流水线。没有你未编码的行为。
- 成熟的中间件生态。 代理轮换、AutoThrottle、重试逻辑和监控钩子都可插拔。社区已经解决了你会遇到的大部分问题。
- 为规模而构建。 在笔记本电脑上运行的项目可通过 Scrapy Cloud 和调度工具扩展到数百万页面。
- 活跃开发。 近期版本增加了 HTTP/2 支持、SOCKS 代理处理和实验性的基于 aiohttp 的下载处理器。
Scrapy 的不足
Scrapy 的核心引擎是 HTTP 爬虫,不是浏览器。它本身不渲染 JavaScript。对于 React、Vue 或任何单页应用,你需要外挂 scrapy-playwright 或外部渲染服务。这是有意的设计选择,让框架保持精简,但意味着动态网站是一个项目决策,而非默认能力。
反机器人处理也是手动的。你需要自行配置代理中间件和封禁检测。Scrapy 给你工具,但当目标网站改变防御时,维护负担由你承担。
Thunderbit:面向非技术团队的一键提取
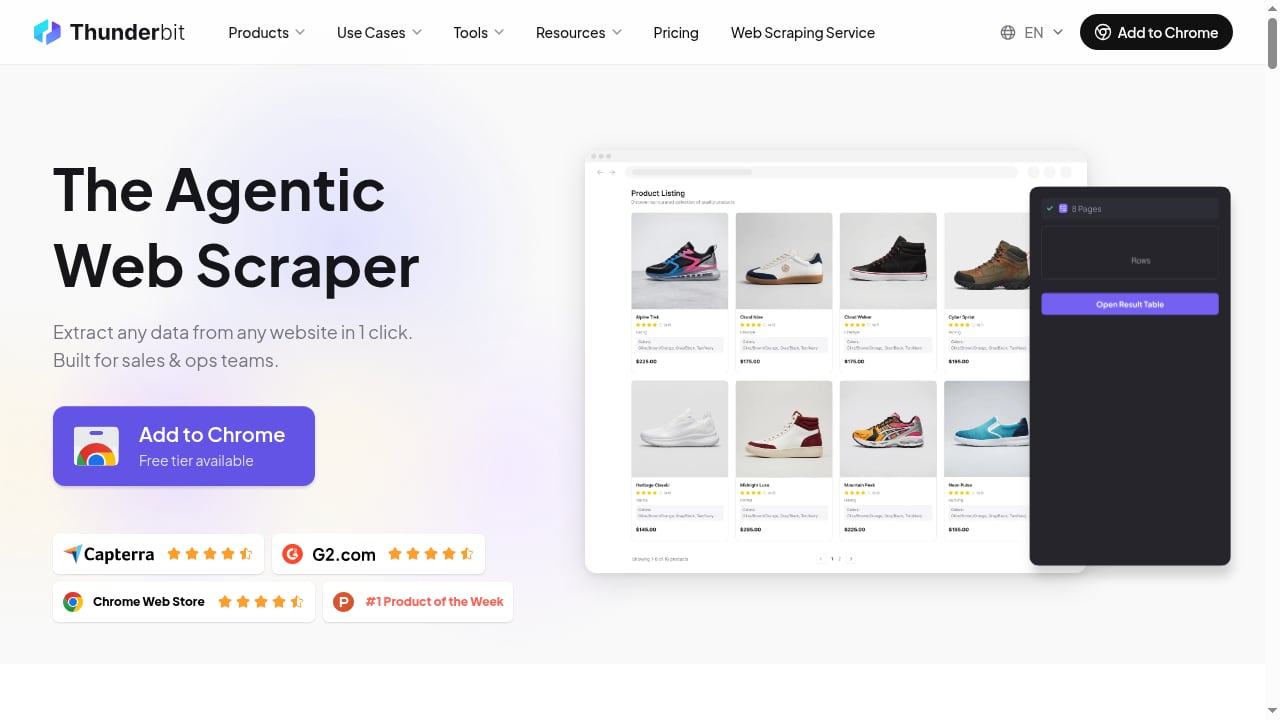
First viewport screenshot of Thunderbit: Agentic Web Scraper - Scrape any website in 1 click.
Thunderbit 首屏截图:智能体网页爬虫 - 一键抓取任何网站。
Thunderbit 采取相反的方法。无需编写代码,你在浏览器中打开页面,点击一键提取,AI 智能体会识别可提取字段——产品列表、职位发布、联系信息——并自动准备它们。
Thunderbit 的优势
- 浏览器工作流零设置。 无需 Python 环境、无需选择器、无需编写模式。销售运营分析师或房地产研究员无需打开代码编辑器即可提取数据。
- 多种界面。 除了 Chrome 扩展,Thunderbit 还提供用于云端收集的 Web App、用于后端工作流的 Open API、用于 Claude 或 Cursor 中 AI 智能体的 MCP Server,以及面向终端用户的 CLI。
- 自然语言字段优化。 你用自然语言指令调整提取规则,而不是正则表达式或 XPath。
- 直接导出目标。 数据流向 Excel、Google Sheets、Airtable 或 Notion,无需自定义流水线代码。
Thunderbit 的不足
Thunderbit 优化的是快速获得第一个数据集,而非深度定制。如果你的架构需要自定义重试逻辑、多步认证流程或与现有数据仓库集成,智能体方法会限制你。它也最适合定向或中等规模的任务,而非大规模定时爬取。
与所有抓取工具一样,Thunderbit 不保证绕过每个网站。它基于用户已打开的渲染页面工作,包括支持的登录会话,但反机器人系统仍可能阻止它。
AdsCrawl:面向开发者的托管云浏览器
Thunderbit 定价方案首屏截图 | Thunderbit。
AdsCrawl 是一个托管云浏览器和浏览器自动化 API。它为需要抓取、测试或监控那些抵抗简单 HTTP 请求的动态网站,但不想维护自己浏览器基础设施的开发者而构建。
AdsCrawl 的优势
真实云 Chromium 与 CDP 访问。 你将 Playwright、Puppeteer 或任何 Chrome DevTools Protocol 客户端连接到实际的云浏览器。这意味着原生 JavaScript 渲染,无需管理浏览器二进制文件、Docker 镜像或自己机器上的内存限制。
内置代理路由。 AdsCrawl 包含 100+ 轮换住宅代理并支持自定义代理。你无需编写代理中间件或维护 IP 池——平台在浏览器会话中处理路由。
无需解析 HTML 的结构化输出。 向 /html 端点发送一次 POST 即可返回渲染后的 HTML、Markdown、JSON 或截图。对于需要干净数据而非原始标记的团队,这消除了整个解析层。
有状态浏览器配置文件。 云浏览器配置文件在任务间持久化设置、Cookie 和指纹。这对于需要一致身份的工作流很重要——监控仪表板、QA 回归测试或认证抓取。
实时交互访问。 connectUrl 和短期控制令牌让你打开实时浏览器会话进行调试或手动干预,而无需离开自动化流水线。
透明的基于积分定价。 免费套餐包含 500 个一次性积分。Hobby 为每月 9 美元,适合独立开发者;Starter 为每月 49 美元,适合小型生产团队;Pro 为每月 199 美元,适合高容量自动化。套餐在每月积分、浏览器并发、配置文件限制和 API 密钥数量上有所不同。
AdsCrawl 最适合的场景
AdsCrawl 不是 Scrapy 爬取调度或 Thunderbit 无代码简单性的替代品。它是为已经知道如何编写浏览器自动化代码,并希望这些代码能可靠地针对棘手动态页面运行的团队提供的基础设施——代理路由、身份持久化和渲染输出由平台处理。
如果你正在评估浏览器基础设施选项,我们的 AdsCrawl vs Steel 对比 更详细地介绍了 CDP 控制、Markdown 提取和代理路由。
正面交锋:每项标准下哪款工具胜出?
获得第一个数据集的时间
Thunderbit 胜出。三步:打开页面、点击提取、查看数据。Scrapy 需要环境设置、生成爬虫、编写选择器和配置流水线。AdsCrawl 需要 API 密钥和一次请求——对于单个页面比 Scrapy 快,但不如点击快。
JavaScript 渲染
AdsCrawl 和 Thunderbit 都原生处理渲染页面。AdsCrawl 通过具有 CDP 访问的真实云 Chromium 浏览器实现。Thunderbit 从用户已打开的页面工作。Scrapy 需要 scrapy-playwright 或外部渲染服务——额外的集成步骤。
定制深度
Scrapy 胜出。你拥有每一行代码。自定义重试逻辑、不寻常的分页模式、多步认证——你的架构要求的任何东西都可能实现。AdsCrawl 通过其 API 模式提供浏览器设置、指纹、代理、Cookie、等待和操作,但它不是通用爬取框架。Thunderbit 优化常见提取模式,而非定制流水线。
代理和反机器人处理
AdsCrawl 对开发者胜出。住宅代理路由内置于平台,具有 100+ 轮换 IP 和自定义代理支持。Scrapy 需要手动中间件配置。Thunderbit 在支持的页面上管理渲染,但不提供同等水平的代理控制。
规模与调度
Scrapy 在大规模定时爬取中胜出。它为数百万页面而构建。AdsCrawl 通过按套餐扩展的浏览器并发限制处理高容量自动化。Thunderbit 更适合定向或中等规模任务,而非持续大规模爬取。
成本可预测性
Scrapy 免费且开源,但你要付出开发者时间、托管和代理成本。AdsCrawl 和 Thunderbit 使用基于积分的定价并公布层级,这让预算更简单,但增加了订阅项。
决策指南:你应该选择哪款工具?
选择 Scrapy 如果:
- 你有 Python 开发者,希望完全控制爬取逻辑。
- 你的目标大多是静态 HTML,或者你愿意集成 scrapy-playwright。
- 你需要按计划爬取数百万页面。
- 你更喜欢开源许可和社区支持,而非供应商关系。
选择 Thunderbit 如果:
- 你的团队是非技术性的,今天就需要电子表格中的数据。
- 你从浏览器中已经能看到的页面提取数据。
- 你想要 AI 辅助字段检测,无需编写选择器。
- 你的量是定向的,而非持续的。
选择 AdsCrawl 如果:
- 你编写 Playwright、Puppeteer 或 CDP 代码,并需要它针对棘手的动态网站运行。
- 你想要托管代理路由和浏览器身份,而无需维护基础设施。
- 你需要通过一次 API 调用获得渲染后的 HTML、Markdown、JSON 或截图。
- 你运行需要状态化浏览器配置文件的生产抓取、QA 或监控工作流。
要更广泛地了解浏览器 API 如何融入 Python 自动化栈,请参阅我们的 Python 框架指南。
相关阅读
- AdsCrawl vs Steel:面向 AI 智能体的浏览器基础设施 - AdsCrawl 与 Steel 对比:CDP 控制、Markdown 提取、反机器人功能、定价,以及哪款浏览器 API 适合 AI 智能体、抓取和自动化。
来源与进一步阅读
First viewport screenshot of Scrapy Knowledge Base | Scrapy.
- Thunderbit vs Scrapy:智能体网页爬虫还是 Python 爬取框架? | Thunderbit - 对比 Thunderbit 与 Scrapy 在智能体无代码提取、Python 爬虫、选择器、流水线、部署、维护、规模和最佳适用工作流方面的差异。
- Scrapy — 用于 Python 的开源网页抓取框架 - Scrapy 是用于网页抓取的主要开源 Python 框架——快速、异步、可扩展且 BSD 许可。受到数百万开发者信赖。
- 12 款最佳开源网页爬虫工具,按许可证类型排序 | Thunderbit - 根据许可证类型、语言以及对静态与动态网站的适用性,对比 2026 年 12 款最佳开源网页抓取工具。
常见问题
我可以将 AdsCrawl 与 Scrapy 一起使用吗?
可以。AdsCrawl 暴露 CDP 端点,因此你可以将 scrapy-playwright 连接到云浏览器会话。这种组合让你获得 Scrapy 的爬取调度和流水线生态,以及 AdsCrawl 的托管渲染和代理路由。
Thunderbit 是 Scrapy 的替代品吗?
不是。它们解决不同的问题。Thunderbit 是一个托管的智能体爬虫,用于无需代码的快速提取。Scrapy 是用于构建自定义爬取流水线的框架。团队有时两者都用——Thunderbit 用于快速一次性数据集,Scrapy 用于生产基础设施。
Scrapy 会渲染 JavaScript 吗?
不会原生渲染。Scrapy 的核心引擎是 HTTP 爬虫。你需要 scrapy-playwright、类似 Selenium 的中间件或外部渲染服务来处理 JavaScript 密集型网站。
AdsCrawl 如何处理反机器人系统?
AdsCrawl 通过 100+ 轮换住宅代理路由请求,并支持自定义代理。它还提供浏览器指纹设置和有状态配置文件,在任务间持久化 Cookie 和身份。没有工具能保证绕过每个网站,但这些功能减少了触发封禁的摩擦。
AdsCrawl 支持哪些输出格式?
AdsCrawl 返回渲染后的 HTML、Markdown、JSON 或截图。你根据是需要原始标记进行解析,还是需要干净的结构化数据进行下游处理来选择格式。
AdsCrawl 有免费套餐吗?
有。免费套餐包含 500 个一次性积分。付费计划从 Hobby 每月 9 美元、Starter 每月 49 美元、Pro 每月 199 美元起,差异在于每月积分、浏览器并发、配置文件限制和 API 密钥数量。
结论
在 AdsCrawl vs Scrapy vs Thunderbit 的对比中没有唯一的赢家——只有适合你团队和任务的正确工具。
Scrapy 仍然是希望掌控爬取每个方面的 Python 开发者的黄金标准。Thunderbit 是非技术用户从网页到电子表格的最快路径。AdsCrawl 填补了它们之间的空白:具有 CDP 访问的托管云浏览器、内置代理路由和结构化输出,适合需要在动态网站上可靠渲染而无需从头构建浏览器基础设施的开发者。
如果你的瓶颈是 JavaScript 渲染、代理管理或浏览器身份持久化,探索 AdsCrawl 的浏览器 API,看看托管云浏览器是否适合你的技术栈。如果你的瓶颈是编写爬虫代码,Scrapy 的文档和社区会很好地服务你。如果你的瓶颈是完全不知道如何编码,Thunderbit 就是为你而构建的。