
2026年用于网页抓取的十大无头浏览器API
从渲染、反爬处理、代理、定价和最佳适用场景等方面,对比2026年用于网页抓取的十大无头浏览器API。
2026年用于网页抓取的十大无头浏览器API
现代网站很少直接返回完整的HTML。商品网格、价格表、仪表盘和信息流都是在JavaScript运行后由浏览器组装而成,因此普通的HTTP请求往往只能返回一个空壳。无头浏览器API通过在云端运行真实的浏览器引擎、执行脚本、等待内容加载,并返回渲染后的HTML、截图或结构化数据,解决了这个问题。
本评测对十个真正属于网页抓取无头浏览器API类别的产品进行了排名。本文面向正在选择基础设施的开发者和数据团队,而不是比较营销页面的采购者。每个条目都包含其排名依据、您应预期的权衡取舍,以及最适合的工作负载。
我们如何评估这些无头浏览器API
没有单一指标能决定抓取技术栈。我们根据已发布的基准测试、产品文档和供应商报告的能力,对以下标准进行了加权:
- JavaScript渲染深度: API能否执行脚本、等待选择器、滚动、点击并处理单页应用?
- 反爬韧性: 代理轮换、浏览器指纹管理、CAPTCHA处理,以及在受保护域名上的成功率。
- 开发者体验: API设计、SDK和CDP支持、输出格式(如HTML、JSON、Markdown和截图)。
- 规模与可靠性: 并发限制、重试行为、正常运行时间承诺和队列处理。
- 定价透明度: 您能否预测每1,000次请求的成本,以及失败的请求是否计费。
- 合规与运营: 审计认证、数据处理政策和支持质量。
在存在独立基准数据的地方,我们会引用它。当供应商发布自己的数据时,我们将其视为供应商报告而非中立数据。
2026年用于网页抓取的十大无头浏览器API
First viewport screenshot of Headless Browser API - HeadlessBrowserAPI.
Headless Browser API - HeadlessBrowserAPI 的首屏截图。
1. Bright Data Web Scraping API
Bright Data排名第一,因为它将最大的代理网络与完整的渲染和解锁流程相结合。在Scrape.do的2026年16个抓取API基准测试中,Bright Data的平均成功率最高,达到98.87%,在Indeed、GitHub、Zillow和Google上达到100%。其网络覆盖195个国家的超过4亿个住宅IP,平台为主要域名提供400多个预构建抓取器。
最适合: 失败请求会产生下游成本的企业级管道、大规模AI训练数据以及防护严密的目标。
注意事项: 沃尔玛、亚马逊产品页面和社交平台等高级域名的每1,000次请求成本高于标准域名。
2. Scrape.do
Scrape.do在同一基准测试中以98.61%的平均成功率紧随其后,在七个测试域名中有五个达到100%成功率。其差异化优势在于延迟:Zillow响应时间为2.6秒,混合平均值为5.5秒。单一端点设计意味着您可以通过查询参数控制渲染、地理路由和输出格式,而Markdown是LLM和RAG摄取的一等返回类型。
最适合: 对延迟敏感的工作负载,如实时价格监控、SERP跟踪和面向用户的搜索功能。
注意事项: 信用乘数适用于JavaScript渲染和高级代理,因此在复杂目标上的实际成本会高于基础费率。
3. Browserbase
Browserbase是一个围绕托管Chromium实例构建的云原生无头浏览器平台。它处理浏览器生命周期、代理轮换、CAPTCHA解决和自动扩展,从而消除了大部分本地基础设施工作。其文档和开发者工具使其成为大规模运行Playwright或Puppeteer而无需维护自己浏览器集群的团队的天然选择。
最适合: 希望以最小DevOps开销获得托管浏览器基础设施的团队。
注意事项: 浏览器环境的深度定制可能不如自托管设置灵活。
4. Zyte
Zyte(前身为Scrapinghub)是该类别中最成熟的平台之一。它将抓取API与AI驱动的结构化提取相结合,因此您可以请求特定字段,而不是解析原始HTML。它在Python生态系统中的悠久历史(包括Scrapy集成)使其成为拥有现有管道的数据工程团队的舒适选择。
最适合: 以Python为中心的工作流以及需要结构化提取而非原始HTML的项目。
注意事项: 平台的广度可能意味着比单一用途API更陡峭的上手曲线。
5. Apify
Apify采用基于actor的方法:您不仅调用渲染端点,还在其平台上运行容器化抓取器。市场包含数百个针对热门网站的预构建actor,底层浏览器自动化支持JavaScript渲染、代理和调度。它适合希望将现成抓取器与自定义代码并用的团队。
最适合: 偏好预构建抓取器和市场模式,而非从头构建每个提取的团队。
注意事项: actor等平台特定概念相比普通REST API增加了一层学习成本。
6. ScrapingBee
ScrapingBee是一个API优先的服务,通过简单的REST接口处理JavaScript渲染和代理管理。希望发送URL并接收渲染后HTML而无需管理浏览器二进制文件的开发者,往往会欣赏其直观的设计。它支持截图和自定义JavaScript片段,以处理交互密集的页面。
最适合: 希望获得干净REST API和可预测集成的开发者。
注意事项: 极高容量或高度专业化的自动化可能需要更具可配置性的平台。
7. ZenRows
ZenRows专注于反爬规避,使用机器学习来适应检测系统。它专为受Cloudflare、DataDome和类似WAF保护的网站设计,在这些网站上标准渲染请求会失败。该API返回渲染后的HTML,并支持高级代理和地理定位。
最适合: 防护严密的网站,其中绕过能力比原始吞吐量更重要。
注意事项: 在最困难目标上的成功率仍可能因域名和日期而异。
8. ScraperAPI
ScraperAPI是一个具有成本效益的选择,提供JavaScript渲染、代理轮换和大型IP池。其渲染参数和渲染指令集允许您点击、输入和等待选择器,涵盖许多单页应用和无限滚动场景。它通常是团队从基本HTTP抓取转向浏览器渲染的切入点。
最适合: 预算有限、复杂度适中且主要针对标准目标的项目。
注意事项: 高级交互和最棘手的反爬系统可能需要更专业的工具。
9. Scrapfly
Scrapfly对开发者友好,拥有详尽的文档、代码示例和强大的社区资源。它将渲染、代理管理和反爬功能整合在一个API中,其学习材料缩短了从首次请求到生产抓取器的时间。重视文档质量的团队往往将其排名高于其原始基准位置。
最适合: 在学习基于浏览器的抓取时希望获得强大文档和示例的开发者。
注意事项: 它在拥挤的中端市场层级中竞争,因此定价和性能应针对您自己的目标进行测试。
10. HeadlessBrowserAPI
HeadlessBrowserAPI是一个专注于JavaScript渲染内容的API。它通过单次调用返回任何页面的完整HTML,处理渲染,并默认包含轮换代理支持以减少封锁。它还提供JPG或PDF格式的全尺寸截图、跨常见格式的图像抓取,以及用于暗网访问的Tor API节点。集成选项包括Puppeteer、Tor和PhantomJS,请求会自动重试最多60秒,然后返回超时错误。
定价基于订阅,分为四个层级:Headless Hatchling每月15美元,3,000次请求;Headless Scraper每月30美元,7,500次请求;Headless Enthusiast每月50美元,15,000次请求;Headless Master每月75美元,30,000次请求。可提供定制计划。
最适合: 需要渲染HTML、截图和可选Tor访问,且希望每月价格可预测的中小型团队。
注意事项: 请求上限低于企业平台,因此极高频操作可能会超出最高层级。
对比表:无头浏览器API一览
First viewport screenshot of Updates - HeadlessBrowserAPI.
Updates - HeadlessBrowserAPI 的首屏截图。
| 产品 | 突出优势 | 定价信号 | 最适合的工作负载 |
|---|---|---|---|
| Bright Data | 98.87%基准成功率,4亿+ IP | 按成功请求付费 | 企业级、受保护网站 |
| Scrape.do | 平均延迟5.5秒,Markdown输出 | 免费增值,每月29美元起 | 延迟敏感的抓取 |
| Browserbase | 托管Chromium,自动扩展 | 按使用量计费 | 避免DevOps的团队 |
| Zyte | AI结构化提取,Scrapy根源 | 定制 | Python数据管道 |
| Apify | Actor市场,预构建抓取器 | 按使用量计费 | 现成抓取器 |
| ScrapingBee | 简单的REST渲染API | 分层 | 直接集成 |
| ZenRows | ML驱动的反爬规避 | 分层 | 防护严密的网站 |
| ScraperAPI | 经济型渲染和代理 | 分层 | 中等复杂度 |
| Scrapfly | 文档和示例 | 分层 | 开发者学习曲线 |
| HeadlessBrowserAPI | 渲染HTML、截图、Tor节点 | 每月15–75美元层级 | 中小型团队 |
如何选择正确的无头浏览器API
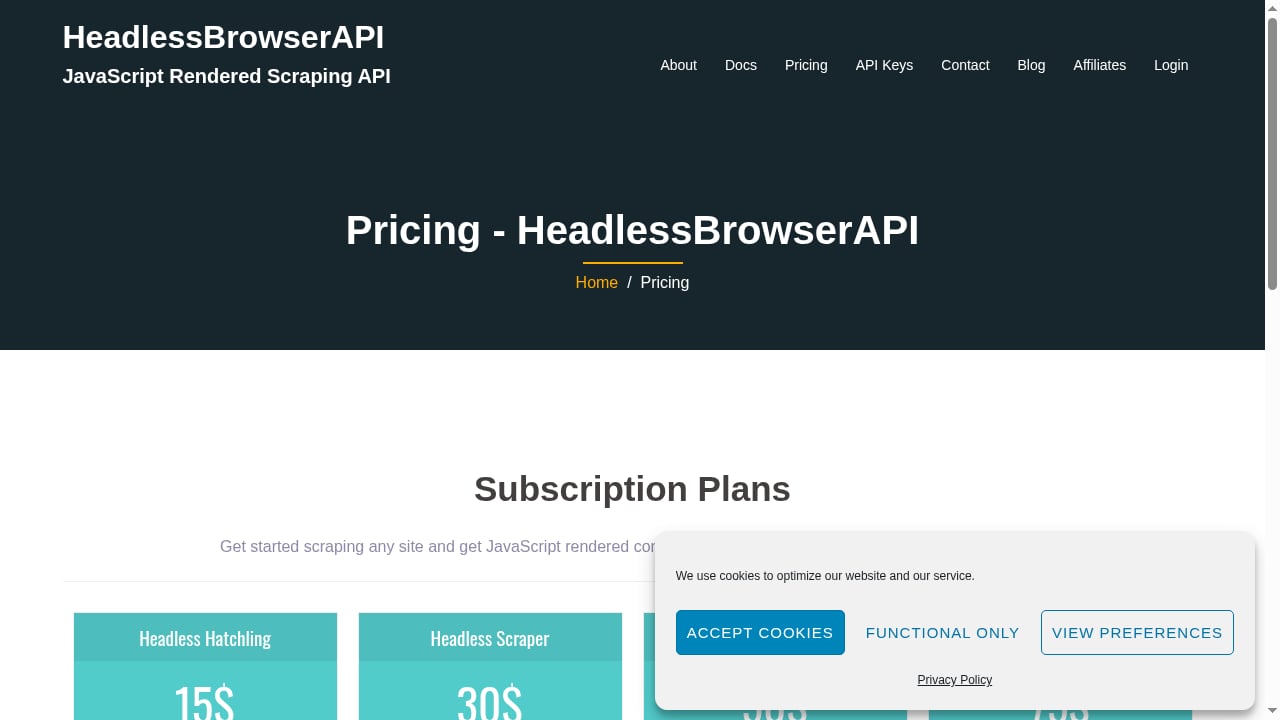
First viewport screenshot of Pricing - HeadlessBrowserAPI.
Pricing - HeadlessBrowserAPI 的首屏截图。
从目标开始,而不是从工具开始。如果您的页面是静态的或脚本很少,渲染API是可选的。如果它们是单页应用、需要登录流程或位于Cloudflare之后,渲染和反爬处理就成为决定性因素。
接下来,估算您的真实请求量,包括重试。98%的成功率听起来与95%相似,但在每月100万次请求时,差异是30,000个失败页面。这就是为什么仅按成功付费的定价和透明的信用乘数比标题费率更重要。
最后,将输出与您的管道匹配。为LLM提供数据的团队通常更喜欢Markdown或JSON,而QA和监控工作流需要截图和全页捕获。如果您还运行多账户浏览器自动化,了解云浏览器会话如何保持状态会有所帮助;我们关于将AdsCrawl与Sendwin结合使用的指南涵盖了该相邻工作流。要了解浏览器API之外更广泛的市场,请参阅我们的AI网页爬取和抓取API综述。
实践示例:渲染一个JavaScript密集型页面
First viewport screenshot of Documentation - HeadlessBrowserAPI.
Documentation - HeadlessBrowserAPI 的首屏截图。
典型的无头浏览器API调用在各提供商之间遵循相同的模式。您发送目标URL,请求渲染,并可选地指定等待条件:
curl "https://api.example.com/render?url=https://example.com/products&render=true&wait_for_selector=.product-grid" \
  -H "Authorization: Bearer YOUR_API_KEY"
响应是完全渲染后的HTML,然后您可以使用首选库进行解析。如果您的工作流还需要捕获视觉证据,截图端点可以在同一管道中返回全页JPG或PDF。
相关阅读
- 如何将AdsCrawl与DataImpulse结合使用 - 将DataImpulse住宅代理连接到AdsCrawl的云浏览器API,以实现可靠的抓取。设置步骤、代码示例和最佳实践。
- AdsCrawl vs Scrape.do vs Selenium:哪个适合您的抓取技术栈? - 比较AdsCrawl、Scrape.do和Selenium在网页抓取和浏览器自动化方面的表现。了解优势、权衡以及哪个工具适合您的工作流。
- AdsCrawl vs Parallel:面向AI代理的Web基础设施 - AdsCrawl与Parallel在AI代理方面的对比:比较云浏览器控制、代理路由、结构化提取、定价,以及哪个适合您的抓取技术栈。
来源与进一步阅读
- 2026年用于网页抓取的最佳无头浏览器 - 探索2026年用于网页抓取的最佳无头浏览器。比较功能、性能和用例,为您的项目选择正确的工具。
- 用于网页抓取的最佳无头浏览器(2026年指南) - 比较用于网页抓取的最佳无头浏览器:性能、检测规避和规模。更新的精选以及Browserbase如何融入其中。
- 2026年9个最佳网页抓取API和工具 - 2026年9个最佳网页抓取API和工具,基于已发布的基准数据排名。比较成功率、定价和反爬性能。
常见问题
什么是无头浏览器API?
无头浏览器API是一种托管服务,它在没有图形界面的情况下运行浏览器引擎,执行页面JavaScript,并返回渲染结果。您通过HTTP调用它,而不是自己安装和管理Chromium或Firefox。
如果我已经使用代理,还需要无头浏览器API吗?
代理会更改您的IP地址,但不会执行JavaScript或处理浏览器指纹。对于动态网站和反爬系统,渲染和浏览器管理是不同的问题,而无头浏览器API可以解决这些问题。
哪个无头浏览器API的成功率最高?
在Scrape.do的2026年16个API基准测试中,Bright Data的平均成功率最高,为98.87%,Scrape.do紧随其后,为98.61%。成功率因目标域名而异,因此请针对您自己的URL进行测试。
无头浏览器API与Puppeteer或Playwright相同吗?
不同。Puppeteer和Playwright是您自己运行的浏览器自动化库。无头浏览器API为您托管该浏览器环境,并将其作为服务公开,通常内置代理和扩展功能。
2026年无头浏览器API的费用是多少?
定价范围从免费层级和按成功付费模式到订阅制。例如,HeadlessBrowserAPI每月15美元起,提供3,000次请求,而企业平台按每1,000次成功请求定价,并且仅对交付的结果计费。
结论
适合您项目的最佳无头浏览器API取决于您是优化成功率、延迟、成本还是控制力。Bright Data在基准成功率和网络规模方面领先,Scrape.do在速度方面领先,而Browserbase等托管平台减少了运营开销。需要以固定月费获得渲染HTML、截图和Tor访问的小型团队可以根据其容量上限评估HeadlessBrowserAPI。
无论您选择哪个,在承诺之前请针对您自己最难的目标进行测试。已发布的基准测试只是一个起点,但您在自己域名上的成功率才是最终重要的数字。