
浏览器任务 API 完全指南:从后台空闲调度到云端自动化
浏览器任务 API 是什么?本文解析后台任务协作调度、扩展程序 API 与云端浏览器自动化三种形态,对比传统爬虫与托管方案,并给出选型与实战建议。
浏览器任务 API 完全指南:从后台空闲调度到云端自动化
当开发者搜索「浏览器任务 API」时,往往带着不同的疑问:有人想知道如何让浏览器在空闲时执行低优先级任务,有人想调用 Chrome 扩展的能力,还有人需要让浏览器在云端自动完成抓取、测试或监控。这三种需求指向完全不同的技术路径,却共用同一个模糊的关键词。
本文先把概念拆开,再给出可落地的代码示例、方案对比与选型建议,帮助你在真实项目中选对工具。
浏览器任务 API 到底指什么
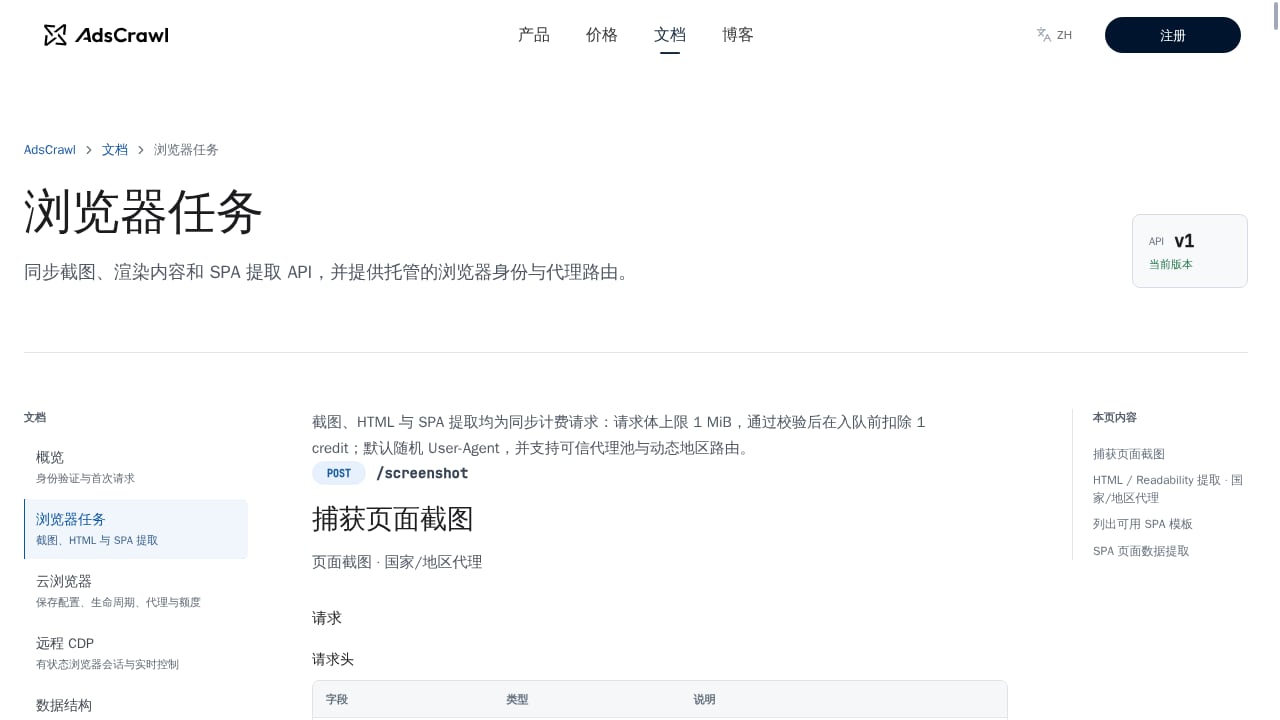
First viewport screenshot of 浏览器任务 | AdsCrawl 文档.
在中文技术语境里,「浏览器任务 API」通常对应三类不同的东西:
- 后台任务协作调度 API:由浏览器决定何时在空闲时间执行你排队的任务,核心接口是
requestIdleCallback()与cancelIdleCallback(),配套IdleDeadline对象。 - 浏览器扩展程序 API:扩展通过
chrome.*或browser.*命名空间调用标签页、存储、网络请求、调试器等能力,属于扩展生态的任务接口。 - 云端浏览器自动化 API:把真实 Chromium 跑在服务器上,通过 HTTP 接口或 CDP(Chrome DevTools Protocol)远程驱动,用于抓取、端到端测试与监控。
判断自己需要哪一类,最简单的办法是问一句:任务运行在谁的浏览器里?如果是用户当前打开的页面,看第一类;如果是你自己安装的扩展,看第二类;如果是服务器上无人值守的浏览器,看第三类。
形态一:后台任务协作调度 API
它解决什么问题
浏览器主线程非常繁忙:渲染待更新的内容、执行页面脚本、接收输入事件、分发事件、处理与操作系统的交互。如果所有 JavaScript 都挤在这条线程上,页面就会卡顿。
requestIdleCallback() 的思路是让浏览器主动告诉你的代码「现在还有多少安全可用的时间」,从而把非紧急工作塞进事件循环的空隙里。
关键规则
- 只用于低优先级任务。回调何时执行、执行几次都不确定,除非你显式设置
timeout。 - 不要超支分配的时间。
timeRemaining()名义上有 50 毫秒上限,但复杂页面里实际可用时间往往更少。 - 不要在空闲回调里改 DOM。此时当前帧已绘制完成,布局改动会强制重排。需要更新界面时,用
requestAnimationFrame()重新调度。 - 避免不可预测耗时的操作,包括在回调里直接 resolve 或 reject Promise。
一个最小可用的任务队列
const taskList = [];
let taskHandle = null;

function enqueueTask(handler, data) {
  taskList.push({ handler, data });
  if (!taskHandle) {
    taskHandle = requestIdleCallback(runTaskQueue, { timeout: 1000 });
  }
}

function runTaskQueue(deadline) {
  while ((deadline.timeRemaining() > 0 || deadline.didTimeout) && taskList.length) {
    const task = taskList.shift();
    task.handler(task.data);
  }
  taskHandle = taskList.length
    ? requestIdleCallback(runTaskQueue, { timeout: 1000 })
    : 0;
}
这段模式来自 MDN 的后台任务 API 文档,要点是:用 timeout 兜底,保证即使没有空闲时间也能每秒推进一次;任务耗尽后把句柄清零,下次入队时重新申请。
什么场景不该用它
需要保证顺序与时限的业务逻辑、需要立即反馈的交互、以及任何会触发布局变化的工作,都不适合放进空闲回调。它更像「锦上添花」的调度器,而不是任务队列的替代品。
形态二:浏览器扩展程序 API
如果你要做的是在用户浏览器里读取或操作页面,扩展 API 才是正解。Chrome 提供了庞大的命名空间集合,常见的任务型接口包括:
chrome.tabs:创建、修改、重排标签页。chrome.scripting:在不同上下文中注入并执行脚本。chrome.storage:存储与跟踪用户数据变化。chrome.alarms:在指定时间或周期性地安排代码运行。chrome.debugger:作为 Chrome 远程调试协议的替代传输通道,可附加到标签页、检测网络交互、调试 JavaScript、修改 DOM 与 CSS。chrome.declarativeNetRequest:用声明式规则屏蔽或修改网络请求,无需拦截请求内容,隐私性更好。
完整的命名空间与权限说明可查阅 Chrome 扩展程序 API 参考。
扩展路线的现实约束
扩展 API 的能力很强,但边界同样明显:
- 需要用户安装,无法覆盖未安装的访客。
- 受清单权限与用户授权限制,敏感能力需要额外申请。
- 运行在用户设备上,无法保证稳定的网络出口、指纹与并发。
- 页面改版或浏览器策略调整都可能影响长期稳定性。
因此,扩展适合「增强用户当前浏览体验」,而不适合「无人值守的大规模数据任务」。如果你的目标是批量抓取或持续监控,请直接看下一节。
形态三:云端浏览器自动化 API
First viewport screenshot of AdsCrawl 文档 | AdsCrawl.
为什么需要它
很多网站的关键数据只存在于渲染后的页面里,没有公开接口。传统爬虫要处理 JavaScript 渲染、反爬策略与页面改版,维护成本高。云端浏览器把真实 Chromium 放在服务器上运行,让自动化脚本以接近真人的方式访问页面。
典型能力清单
一个成熟的云端浏览器平台通常提供:
- 同步返回渲染后的 HTML、Markdown、JSON 或截图。
- 支持 Playwright、Puppeteer 或任意 CDP 客户端接入。
- 住宅代理路由或自定义代理,保证出口 IP 的稳定性与地域分布。
- 有状态的浏览器配置文件,让登录态、Cookie 与设置跨任务持久化。
- 独立的远程 CDP 会话,用于需要直接控制浏览器的复杂流程。
- 实时交互访问,通过连接地址与短期令牌人工接管排查问题。
AdsCrawl 正是这一类平台:它提供托管云 Chromium 与浏览器自动化 API,开发者可以把 Playwright、Puppeteer 或任意 CDP 客户端接到真实云浏览器上,通过 POST /html 同步获取渲染内容,按视口或选择器截图,用模板抽取 SPA 页面数据,并借助持久化配置文件与代理路由完成生产级任务。它的计费按积分透明划分,从免费额度到面向高并发团队的付费档位都有覆盖。
一个抓取任务的典型流程
1. 创建或复用一个云浏览器配置文件(保留 Cookie 与指纹设置)
2. 指定代理路由(住宅代理或自有代理)
3. 发送 POST /html,等待页面渲染完成
4. 选择返回格式:HTML / Markdown / JSON / 截图
5. 解析结构化字段,写入数据库或下游系统
如果流程需要登录、多步点击或表单提交,则改用远程 CDP 会话,让 Playwright 或 Puppeteer 直接接管浏览器上下文。
与传统爬虫的对比
| 对比项 | 传统 HTTP 爬虫 | 云端浏览器自动化 |
|---|---|---|
| 动态渲染页面 | 需额外处理或直接失败 | 原生支持 JavaScript 渲染 |
| 反爬应对 | 依赖请求头与频率控制 | 真实浏览器行为 + 代理路由 |
| 页面改版 | 选择器失效需改代码 | 可结合模板与等待策略降低维护量 |
| 并发与出口 | 受本机网络限制 | 由云端并发与代理池决定 |
| 登录态保持 | 需自行管理 Cookie | 配置文件持久化 |
合规与工程注意事项
- 只采集公开信息,遵守目标网站的服务条款与
robots.txt。 - 控制请求频率,避免对目标站点造成压力。
- 及时关闭不再使用的浏览器会话,控制资源开销。
- 复杂验证码场景仍有局限,需要提前评估。
三种形态如何选型
可以用三个问题快速定位:
- 任务跑在用户页面里吗? 是 → 后台任务协作调度 API,用于低优先级、可延迟的工作。
- 任务需要读取或操作用户浏览器吗? 是 → 扩展程序 API,但接受安装门槛与权限限制。
- 任务需要无人值守、批量、跨地域运行吗? 是 → 云端浏览器自动化 API。
多数生产级数据项目最终会落在第三条路径上,因为只有它能同时解决渲染、代理、并发与身份持久化四个问题。如果你正在评估具体平台,可以参考 2026 年十大云浏览器自动化与网页数据提取 API 的横向评测,或对比 AdsCrawl 与 Steel、Axiom 的浏览器基础设施差异 来判断哪种技术栈更贴合团队现状。
实战建议:把三种 API 组合起来
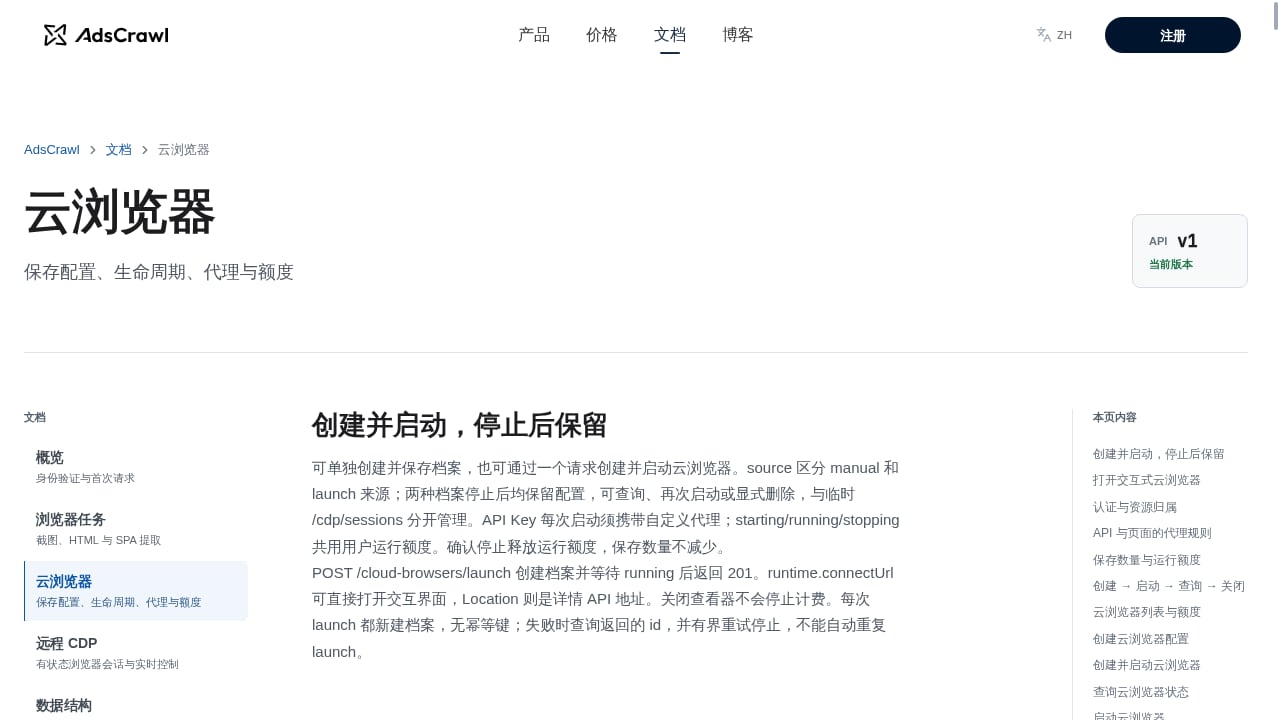
First viewport screenshot of 云浏览器 | AdsCrawl 文档.
真实项目很少只用一种接口。一个常见的组合是:
- 用扩展 API 在用户浏览器中做轻量的页面增强与快捷操作。
- 用后台任务协作调度 API 处理扩展内的低优先级计算,避免阻塞界面。
- 用云端浏览器 API 承担后台的批量抓取、价格监控与端到端测试。
例如做竞品价格监控时,云端任务负责渲染页面并抽取价格字段,下游系统负责比对与告警。想了解完整链路,可以参考 如何将 AdsCrawl 与 Price2Spy 结合用于价格监控 中的设置步骤;如果目标是测试而非采集,将 AdsCrawl 与 Playwright 结合使用 的 CI 示例会更直接。
常见问题
First viewport screenshot of 远程 CDP | AdsCrawl 文档.
requestIdleCallback 能保证任务一定执行吗?
不能。空闲回调只在浏览器判断有空闲时间时运行。设置 timeout 可以让它在超时后强制执行,但代价是可能引入延迟或动画卡顿,因此只在确有需要时使用。
空闲回调里可以修改 DOM 吗?
不建议。回调执行时当前帧已绘制完成,布局计算也已结束,此时改动会触发强制重排。需要更新界面时,用 requestAnimationFrame() 重新调度。
浏览器扩展 API 能替代云端浏览器吗?
不能。扩展依赖用户安装与授权,运行在用户设备上,无法保证稳定的出口 IP、指纹一致性与高并发。批量、无人值守的任务应使用云端方案。
云端浏览器 API 支持哪些客户端?
主流平台通常支持 Playwright、Puppeteer 以及任意 CDP 客户端。以 AdsCrawl 为例,它同时提供同步渲染内容提取、截图、模板化 SPA 数据抽取与独立远程 CDP 会话,开发者可以按任务复杂度选择接入方式。
什么时候应该用远程 CDP 会话而不是简单的 HTTP 接口?
当流程涉及登录、多步交互、条件等待或复杂表单提交时,简单的同步接口不够用。远程 CDP 会话让你直接控制浏览器上下文,适合这类长链路任务。
如何控制云端浏览器任务的成本?
主要看三点:并发数、单次任务的浏览器存活时长、以及是否复用持久化配置文件。合理复用配置文件和及时关闭会话通常比单纯压低并发更有效。
结语
「浏览器任务 API」不是一个单一接口,而是三种不同层次的能力:页面内的空闲调度、扩展生态的任务接口、以及云端浏览器的自动化控制。先明确任务运行在谁的浏览器里,再选择对应的技术路径,能避免大量返工。对于需要稳定渲染、代理路由与结构化输出的生产场景,云端浏览器自动化 API 往往是唯一能同时满足可靠性、并发与身份一致性的方案。
Related reading
- 2026年十大网页抓取浏览器扩展 - 2026年十大网页抓取浏览器扩展的排名评测,包含评估标准、价格信号,以及何时应转向云端API的指导。
- 如何将 AdsCrawl 与 Price2Spy® 结合用于价格监控 - 了解 AdsCrawl 的云浏览器 API 如何将渲染后的竞争对手数据输入 Price2Spy,实现可靠的价格监控,包含设置步骤和示例。
- AdsCrawl vs Parallel vs Remote Browser:AI 智能体 Web 技术栈 - 对比 AdsCrawl、Parallel 与 Remote Browser:面向 AI 智能体浏览器基础设施的渲染提取、搜索与研究 API,以及远程 CDP 会话。
Sources and further reading
- OpenClaw 浏览器自动化:突破 API 边界的高效数据采集实战 - Tencent Cloud - OpenClaw Browser Automation: Efficient Data Extraction Beyond API Boundaries – A Practical Guide OpenClaw is a browser automation tool designed to extract data from websites where tradit...