
WebHarvy 评测 2026:一次性付费的可视化采集器实测
WebHarvy 实操评测:点击式采集、AI/LLM 提取、MCP 支持、价格信号、局限,以及 2026 年谁该购买。
WebHarvy 评测:面向非程序员的一次性付费可视化采集器
WebHarvy 在一个通常三年内就会淘汰桌面软件的市场中,悄然存活了十多年。它的卖点刻意反潮流:一款 Windows 点击式采集器,一次性授权、不依赖云、没有月费。v8 版本新增了 AI 与 LLM 提取,以及面向 Claude Desktop 的 MCP 服务器,这改变了一些买家的权衡。本评测涵盖实际可用的功能、卡壳之处,以及如何判断它是否适合你的技术栈。
WebHarvy 是什么以及如何工作
First viewport screenshot of WebHarvy Support.
WebHarvy - 可视化网页采集器首屏截图。一次付费,永久采集。
WebHarvy 是一款面向 Windows 的可视化网页采集应用。你在其内置浏览器中加载页面,点击想要的数据,软件会推断该点击背后的重复模式。如果商品列表有 40 行,点击一个价格就能教会 WebHarvy 抓取全部 40 行。无需编写选择器语法、无需 XPath,也无需配置 Python 环境。
当前版本内置基于 Chromium 的浏览器,因此通过 JavaScript 或 AJAX 渲染内容的页面,其行为与普通浏览器会话一致。这一点很重要,因为现代电商、房地产和目录网站中很大一部分不再在首次请求时返回可用的 HTML。
核心能力一览
- 模式检测: 点击一次,即可采集页面上所有相似条目。
- 分页处理: 数字链接、“加载更多”按钮、无限滚动,以及预定义 URL 列表。
- 分类爬取: 一次配置即可从列表页跟进到子分类。
- 搜索表单自动化: 输入关键词列表,WebHarvy 会提交搜索并采集每组结果。
- 导出目标: Excel、CSV、JSON、XML、TSV,以及直接写入 MySQL、SQL Server、PostgreSQL 和 Oracle。
- 图片采集: 下载文件到本地,或仅捕获图片 URL。
- 逃生通道: 正则表达式和注入 JavaScript,用于点击不够精确的场景。
v8 新增功能:AI、LLM 和 MCP
最引人注目的变化是 AI 辅助提取。你可以通过 Ollama 或 LM Studio 将 WebHarvy 指向本地模型,或指向 OpenAI、Anthropic、Gemini 等云服务商。实际用途是非结构化内容:在采集完成后生成摘要、运行情感分析,或将杂乱的文本字段转换为规范化值。
第二项新增功能是 MCP 服务器。将 WebHarvy 连接到 Claude Desktop 或其他兼容 MCP 的客户端,你就能用自然语言描述采集任务,让模型驱动浏览器。这对探索性工作确实有用,但当你需要大规模可复现输出时,它并不能替代精心配置的采集器。
理想用户与真实用例
如何通过跟随链接采集数据 | WebHarvy 用户指南首屏截图。
WebHarvy 适合特定人群:需要定期获取结构化数据、但不想维护代码的 Windows 用户。这比厂商营销暗示的群体更窄,但确实存在。
非常适合:
- 市场与价格研究。 跟踪数百到数千个 SKU 的竞品价格、每周特价或目录变化。
- 线索与目录提取。 从公开目录中提取企业名称、地址、电话和邮箱。
- 房地产与房源聚合。 跨分页房源网站收集房产详情。
- 学术与政策研究。 一位有记录的用户在 20 个地区、约 5,000 种商品上进行了超过九个月的每周超市价格采集。
- 小企业数据录入替代。 一位外卖运营者反馈,WebHarvy 免去了全职数据录入岗位的需求。
不太适合:
- 需要跨数百个并发工作器进行分布式采集的团队。
- 只有 macOS 或 Linux 可用的环境。
- 必须在 CI/CD 中无头运行、且没有 Windows 虚拟机的流水线。
- 需要与 Python 数据栈深度集成的项目。
值得付费的优势
WebHarvy 支持首屏截图。
学习曲线确实很短
大多数用户能在一小时内配置好第一个采集器。点击即检测模型消除了采集的最大障碍:编写能在轻微 DOM 变化后仍存活的选择器。对非开发者而言,仅此一点就足以证明授权费合理。
一次性定价改变算法
订阅制采集器无论你是否采集都收费。如果你的工作负载是突发性、季节性或不大的量,与按请求或按月计划相比,永久授权可在一两年内回本。代价是你自己承担维护负担,而不是租用他人的基础设施。
本地执行与数据控制
由于 WebHarvy 在你的机器上运行,采集的数据不会经过第三方云,除非你刻意通过云端 LLM 路由。对于处理敏感或受监管数据的团队,这相比基于 API 的采集服务是显著优势。
反封锁能力好于预期
浏览器模拟正常用户会话,这有助于应对 Cloudflare 保护的网站,而无头工具会被拒绝。支持代理服务器、VPN 和轮换代理列表,以及请求延迟控制。
支持服务口碑很好
在多位用户评价中,一致的主题是快速、个性化的支持,包括针对棘手采集器的屏幕录制演示。对于小厂商,这种响应速度是真正的差异化优势。
局限与诚实的权衡
仅限 Windows,且不会改变
没有原生 macOS 或 Linux 版本。你可以在 AWS、Azure 或其他提供带远程桌面 Windows 虚拟机的云服务商上运行 WebHarvy,这样无需占用自己的 PC 即可 24/7 运行。但这会增加跨平台工具本不需要的成本和管理工作。
规模受限于你的机器
WebHarvy 并非为大规模并行爬取而构建。如果你需要数千个并发请求、分布式队列或弹性扩展,你看错了工具类别。浏览器自动化平台或云采集 API 会更适合你。
CAPTCHA 仍需人工
WebHarvy 可以用保存的凭据登录,并允许你手动解决 CAPTCHA,之后采集继续。对于偶发中断可行,但在防护严格的网站上进行大批量任务会很痛苦。
AI 功能是附加的,不是变革性的
LLM 集成对非结构化文本的后处理有用。它不会神奇地理解网站结构或修复损坏的采集器。把它当作便利层,而非配置的替代品。
文档和版本信号混杂
公开评测引用较旧的版本号和 2017 年的发布日期,可能让产品显得过时。厂商自己的网站记录了支持 AI 和 MCP 的 v8,因此差异主要是文档和 SEO 问题,而非产品问题。不过,购买前请核实当前版本。
设置:预期流程
- 在 Windows 上安装。 从厂商网站下载并安装。提供 15 天试用,足以验证真实用例。
- 加载目标页面。 在内置浏览器中输入 URL。
- 点击第一个数据点。 WebHarvy 会高亮相似元素并提出模式。确认或调整。
- 添加字段。 点击其他列(价格、SKU、图片、链接)以构建行模式。
- 配置分页。 指向下一页链接、加载更多按钮或滚动行为。
- 可选:添加分类或关键词。 对于分类爬取或搜索表单自动化,一次性定义输入列表。
- 可选:连接 AI。 为提取和转换步骤配置 Ollama、LM Studio、OpenAI、Anthropic 或 Gemini。
- 可选:连接 MCP。 如果你想要自然语言控制,将 WebHarvy 接入 Claude Desktop。
- 导出或调度。 写入 Excel、CSV、JSON、XML、TSV 或数据库,并设置调度器进行重复运行。
现实的首次会话成果是一个可用的单页采集器。多页、分类和关键词工作流需要更长时间,但仍无需代码即可实现。
价格信号与价值评估
WebHarvy 以一次性购买形式出售,没有月度订阅。早期版本的公开评测数据提到单用户授权起价约 99 美元/年,但厂商当前的定位强调永久授权模式。由于价格在不同版本间有变化,购买前请直接在厂商网站上确认当前档位和授权条款。
授权包含在特定期限内的免费更新和支持,据厂商称 bug 修复无限期覆盖。15 天试用是测试点击即检测模型能否处理你特定目标网站的正确方式。
价值经验法则: 如果你的采集需求稳定但不大,且否则要支付一年或更长时间的月度订阅,一次性模式胜出。如果你的需求大、突发性强或需要分布式基础设施,考虑到 Windows 虚拟机和自己的维护时间,按使用量计费的云服务总成本可能更低。
WebHarvy 与替代方案对比
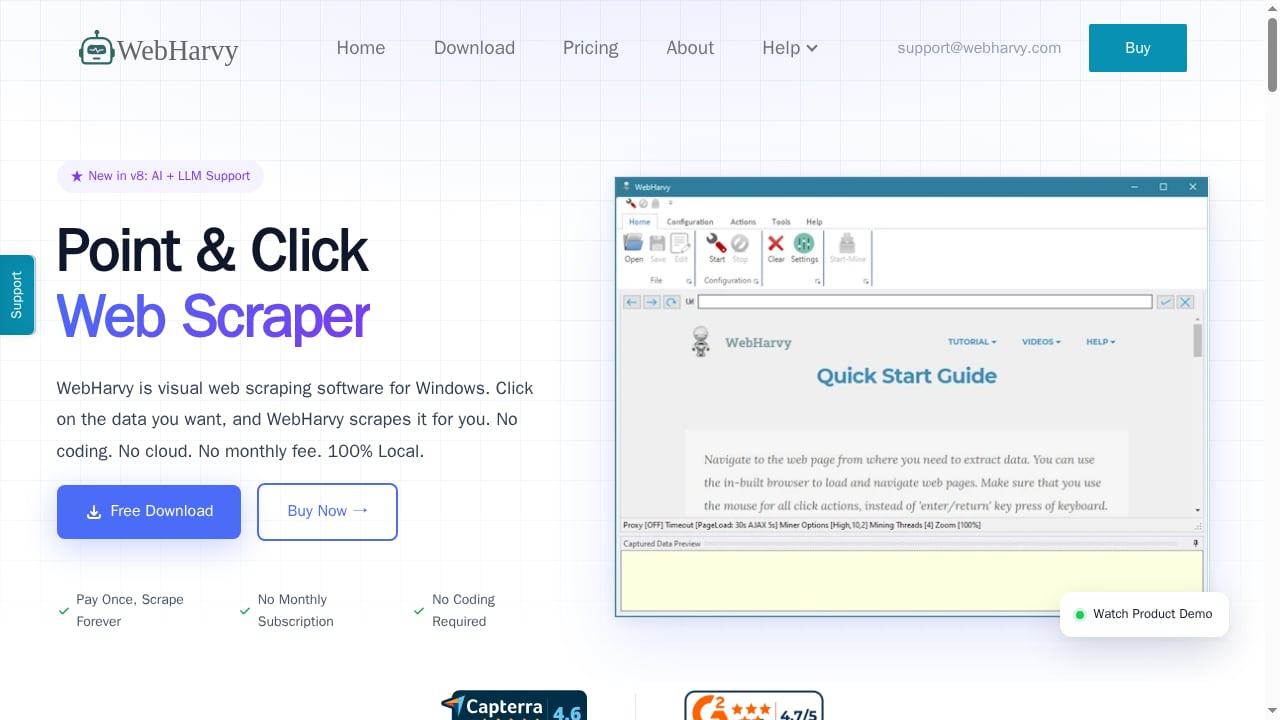
First viewport screenshot of WebHarvy - Visual Web Scraper. Pay Once, Scrape Forever..
编辑采集器配置 | WebHarvy 用户指南首屏截图。
无代码采集市场分为三大阵营,WebHarvy 坚定地属于其中之一。
| 方式 | 示例工具 | 最适合 | 权衡 |
|---|---|---|---|
| 桌面无代码 | WebHarvy | Windows 用户、一次性预算、本地数据控制 | 仅限 Windows、规模有限 |
| 云无代码平台 | Apify、Bright Data | 需要规模、调度和托管代理的团队 | 订阅或按使用量计费 |
| 开发者框架 | Playwright、Puppeteer、Scrapy | 完全控制、CI/CD 集成、自定义逻辑 | 需要编码和维护 |
如果你正在权衡无代码与代码优先选项,我们的 AdsCrawl vs Scrapy vs Thunderbit 对比分析了每种方式的适用场景。对于需要浏览器级控制与云执行的团队,Playwright Node.js 客户端指南 涵盖了设置、动态页面处理和云浏览器扩展。
还值得注意的是,更广泛的市场正转向 AI 驱动的自动化。我们的 2026 年十大 AI 浏览器自动化平台 排名展示了领先选项在反机器人处理、会话持久性和成本方面的比较。
决策标准:你应该购买 WebHarvy 吗?
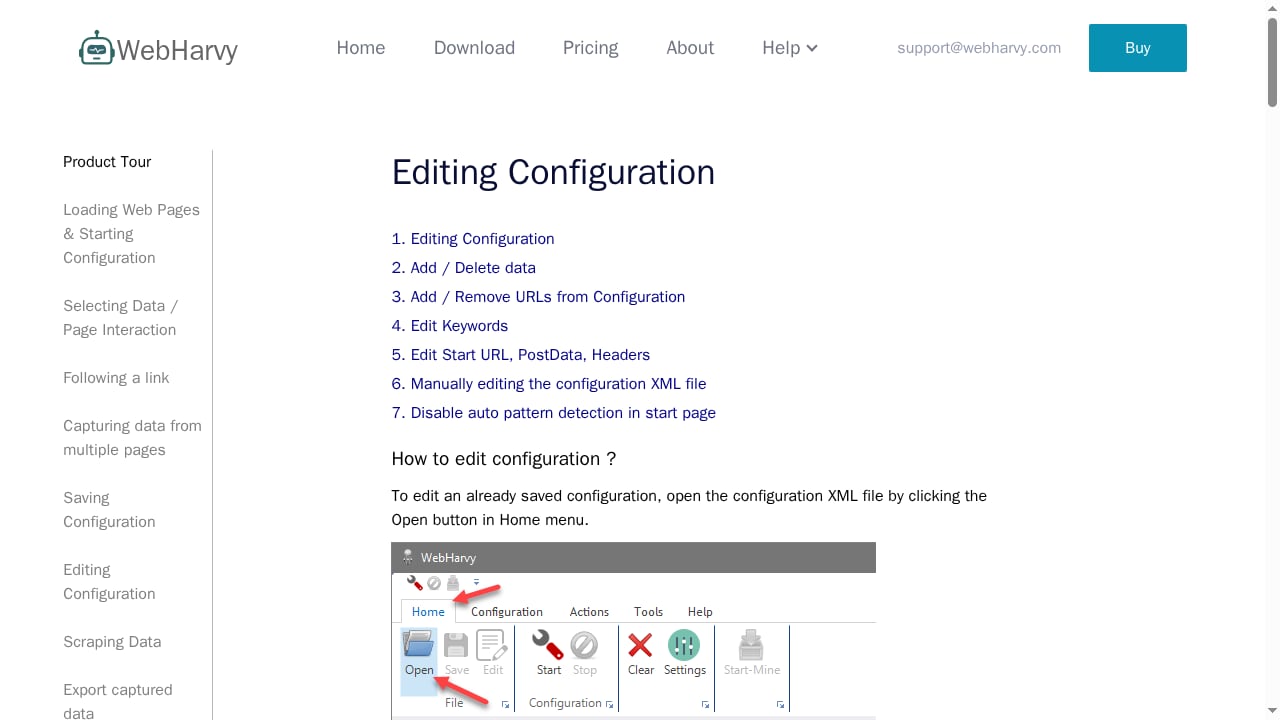
First viewport screenshot of Editing Scraper Configuration | WebHarvy User Guide.
诚实地回答这些问题。
购买 WebHarvy,如果:
- 你使用 Windows 并将继续使用 Windows。
- 你的采集量在每次运行数百到低数千页。
- 你想避免经常性订阅费用。
- 你重视本地执行和数据隐私。
- 你不是程序员,也不想成为程序员。
跳过 WebHarvy,如果:
- 你需要 macOS 或 Linux 支持。
- 你需要分布式、高并发采集。
- 你的工作流位于 Python 或 Node.js 流水线内。
- 你需要大规模托管代理轮换和 CAPTCHA 解决。
- 你想要完全云托管、零维护的设置。
中间路线: 许多团队用 WebHarvy 进行探索性和中等量工作,同时保留云 API 处理大任务。两者并不互斥。
相关阅读
- Playwright Node.js 客户端:设置、采集和云浏览器 - 了解 Playwright Node.js 客户端如何工作:安装、启动浏览器、采集动态页面,以及用云浏览器 API 和代理扩展。
- 2026 年十大 AI 浏览器自动化平台:排名 - 我们按反机器人处理、会话持久性、成本和规模对 2026 年十大 AI 浏览器自动化平台进行了排名。看看哪个适合你的技术栈。
- 如何将 AdsCrawl 与 Puppeteer 配合使用:云浏览器指南 - 通过 CDP 将 Puppeteer 连接到 AdsCrawl 的云 Chromium。设置、完整 Node.js 示例、代理路由、会话清理和常见陷阱。
来源与延伸阅读
First viewport screenshot of How to Scrape Data by Following Links | WebHarvy User Guide.
- WebHarvy 评测 - 使用直观的网页采集器 WebHarvy,通过高级自动化功能轻松从网站提取数据、图片、邮箱和 URL
- WebHarvy - 可视化网页采集器。一次付费,永久采集。 - 通过点击式用户界面轻松从任何网站采集数据。无需编码。
- 最佳网页采集服务:2026 年对比指南 - 越来越多行业依赖数据做出明智选择,这意味着拥有快速、可靠的结构化网页数据收集方式不再是可选项。这是核心需求。在本概述中,我们将审视 2026 年顶级网页采集服务,涵盖它们提供的内容、定价模式、最适合的用户及其独特优势。无论你是在扩展数据基础设施还是淘汰过时工具,本指南都能帮助你做出明智、匹配的选择。
常见问题
WebHarvy 真的是一次性付费吗?
厂商将其宣传为“一次付费,永久采集”,没有月度订阅。较早的第三方评测提到年度授权定价,因此购买前请在官网确认当前授权条款。
WebHarvy 需要编码吗?
不需要。配置是点击式的。正则表达式和自定义 JavaScript 作为可选高级工具提供,但标准采集不需要它们。
WebHarvy 能采集 JavaScript 密集型网站吗?
可以。它使用基于 Chromium 的浏览器在提取前渲染页面,因此支持 JavaScript、AJAX 和动态分页。
CAPTCHA 和封锁怎么办?
WebHarvy 可以用保存的凭据登录,并在出现 CAPTCHA 时允许你手动解决。代理服务器、VPN 和轮换代理列表有助于减少封锁,请求延迟可配置。
支持哪些导出格式?
Excel、CSV、JSON、XML 和 TSV 文件,以及直接导出到 MySQL、SQL Server、PostgreSQL 和 Oracle 数据库。
我可以在云中运行吗?
可以,在任何提供带远程桌面 Windows 虚拟机的云平台上,例如 AWS 或 Azure。这能实现 24/7 采集而不占用本地机器。
AI 和 MCP 功能有什么用?
AI 集成通过 Ollama 或 LM Studio 连接本地模型,或连接 OpenAI、Anthropic 和 Gemini 等云服务商,用于摘要、情感分析和数据转换。MCP 服务器让 Claude Desktop 等兼容 MCP 的客户端用自然语言驱动 WebHarvy。
使用 WebHarvy 进行网页采集合法吗?
采集公开可用数据通常是允许的,但你应查看每个网站的服务条款和适用法律,并避免未经许可收集个人或受版权保护的数据。厂商也持相同立场。
结论
WebHarvy 并不试图赢得功能军备竞赛。它靠一个更窄的承诺取胜:有适度、重复采集需求的 Windows 用户可以一次购买,点击几个页面,就能将干净数据导入 Excel 或数据库,而无需编写一行代码。v8 的 AI 和 MCP 新增功能让它在已转向云和代码优先工具的市场中保持相关性。
局限是真实且可预测的:仅限 Windows、受机器容量限制,并且对敌对网站依赖手动解决 CAPTCHA。如果这些限制不影响你的工作流,一次性定价模式确实有吸引力。如果影响,云采集 API 或浏览器自动化框架会更适合你。
明智的做法是用 15 天试用在你实际的两个或三个目标网站上测试。如果模式检测在最混乱的那个上仍然有效,你就有答案了。