
2026年十大网页抓取API平台:排名与对比
我们根据成功率、渲染能力、定价和开发者体验,对2026年十大网页抓取API平台进行了排名。比较并选择适合您的API。
2026年十大网页抓取API平台:排名与对比
2026年的网页抓取,重点不在于编写请求,而在于突破其前方的防御。Cloudflare、DataDome、Kasada和PerimeterX现在能在几秒内阻止简单的抓取器,而单页应用只有在浏览器执行JavaScript后才会渲染内容。网页抓取API吸收了这种复杂性:您发送一个URL,提供商处理代理轮换、浏览器渲染、验证码解决、重试和扩展,然后您获得HTML、Markdown或结构化JSON。
本排名涵盖十个真正属于网页抓取API类别的平台。每个条目都基于公开证据进行评估:基准成功率、文档化定价、功能深度和开发者情绪。目标不是选出一个通用赢家,而是帮助您将平台与您的工作负载相匹配。
我们如何评估这些平台
可扩展网页抓取API用于数据提取的首屏截图 | Scrapingdog。
我们从六个维度对每个产品进行评分,并根据它们对实际生产结果的影响程度进行加权:
- 受保护域名的成功率——最重要的单一指标。一个在Cloudflare上失败的廉价API,比一个能工作但昂贵的API成本更高。
- JavaScript渲染和浏览器控制——API是否执行客户端代码,以及您是否可以与页面交互(点击、填写、导航)还是只能获取页面。
- 输出质量——原始HTML、干净的Markdown或基于模式的JSON。Markdown和JSON减少了下游解析工作,特别是对于LLM和RAG管道。
- 定价透明度——渲染和高级代理的文档化积分乘数,以及失败请求是否计费。
- 开发者体验——SDK、文档、错误消息和集成生态系统。
- 规模和合规性——并发限制、正常运行时间承诺以及SOC 2、ISO 27001、GDPR和CCPA等认证。
我们参考了两个公开基准:Scrape.do的2026年基准测试,涵盖七个困难域名上的16个抓取API;以及Proxyway的2025年网页抓取API报告,涵盖15个高度保护网站上的11个参与者。当供应商发布自己的基准时,我们将这些数字视为方向性而非独立性。
2026年十大网页抓取API平台
First viewport screenshot of ScrapingBee – The Best Web Scraping API.
ScrapingBee – 最佳网页抓取API的首屏截图。
1. Bright Data — 企业级规模的最佳整体选择
在Scrape.do的2026年基准测试中,Bright Data在16个API中平均成功率最高,达到98.87%,在Indeed、GitHub、Zillow和Google上达到100%。其网络覆盖195个国家的4亿多住宅IP,并提供437多个预构建抓取器,覆盖Amazon、LinkedIn、TikTok、Zillow和其他主要域名。
优势: 对比中最大的代理网络,仅按成功付费的计费方式,公布的99.99%正常运行时间SLA,以及GDPR、CCPA、ISO 27001和SOC 2合规性。批量处理支持每次API调用最多5,000个URL。
权衡: 高级域名如Walmart、Amazon产品页面和社交平台的计费率高于标准域名。平台的广度可能超出小型项目的需求。
最适合: 企业数据管道、AI训练数据,以及抓取失败会产生下游成本的工作负载。
2. Scrape.do — 速度敏感型工作负载的最佳选择
Scrape.do在其2026年基准测试中以98.61%的平均成功率紧随其后,并在该测试中记录了最快的Zillow响应时间,为2.6秒,混合平均为5.5秒。它采用单端点设计:通过查询参数控制高级行为,如render=true、super=true、output=markdown和geoCode=US,因此可以轻松集成到任何HTTP客户端中,无需新的SDK。
优势: 专注于延迟的架构,覆盖数据中心、住宅和移动池的1.1亿多IP,一流的Markdown输出,以及每月1,000次请求的免费增值层。Hobby计划起价为每月29美元,可进行250,000次请求。
权衡: 基础计划适用积分乘数——JavaScript渲染消耗5个积分,高级代理消耗10个积分,两者结合消耗25个积分。每月约350万次请求以上需要企业定价。
最适合: 实时价格监控、面向用户的搜索,以及响应时间重要的SERP工作负载。
3. ScrapingBee — 初学者和清晰文档的最佳选择
ScrapingBee是一个网页抓取API,处理代理、无头浏览器和反机器人防御,让团队可以专注于提取。它为4,500多名开发者提供服务,提供一个主要的HTML API,具有JavaScript渲染、轮换和高级代理、地理定位、截图以及使用CSS或XPath选择器的提取规则。专用抓取器API覆盖Google、Amazon、Walmart、ChatGPT、Gemini、YouTube和员工搜索,以及一个快速搜索API。
AI就绪功能包括用JSON定义抓取规则、使用AI Query描述数据需求,以及与LLM、RAG和分析管道集成。集成包括CLI、Remote MCP、n8n、Make、Zapier和LangChain。定价从Freelance每月49美元到Enterprise 24每月1,599美元不等,提供1,000积分的免费试用,无需信用卡。基于100多条评论,它保持4.9的评分。
优势: 清晰的文档、官方Python SDK和温和的学习曲线。专用抓取器端点消除了常见目标的的选择器维护。
权衡: JavaScript渲染和高级代理适用积分乘数,因此高容量渲染工作负载需要仔细的成本建模。
最适合: 刚接触抓取API的开发者,以及希望为搜索和电子商务目标提供专用端点的团队。
4. Scrapingdog — 平台特定端点的最佳选择
Scrapingdog提供一个单一API来提取数据,无需管理代理、无头浏览器或验证码。它为搜索引擎(Google Search、Google Maps、Google Trends)、电子商务平台(Amazon、Walmart、eBay、Flipkart、Myntra、Baidu)和社交媒体(LinkedIn、X/Twitter、TikTok、YouTube)提供专用API。该平台处理JavaScript渲染、自定义标头、高级住宅代理、地理定位和会话,返回结构化JSON或HTML。
它受到1,000多名开发者的信任,评分为4.8,并提供30天免费试用,包含100个免费积分,无需信用卡。定价从免费层扩展到每月高达数十亿次请求的企业计划,失败请求从不收费。
优势: 广泛的平台特定覆盖、结构化JSON输出,以及失败请求不收费的政策。它适合SEO专业人员、电子商务企业、数据分析师和从事SEO监控、价格跟踪、潜在客户生成和市场研究的开发者。
权衡: 专用端点是主要吸引力;需要低级浏览器控制的团队可能更喜欢基于CDP的云浏览器。
最适合: SEO监控和电子商务价格跟踪,其中预构建端点可节省开发时间。
5. Firecrawl — LLM和RAG管道的最佳选择
Firecrawl专为AI驱动的工作流而构建。它返回干净的Markdown,使用的令牌比原始HTML少约67%,这在数千个页面上会迅速累积。它提供七个端点:Scrape、Crawl、Map、Search、Agent、Interact和Parse。Interact端点允许您抓取页面并立即使用自然语言或代码点击、填写或导航,然后提取出现的内容。
优势: 与LangChain和LlamaIndex的原生集成,SOC 2 Type 2合规性,以及每月1,000积分的无密钥免费层,无需注册。Agent端点可以自主导航复杂网站并返回结构化数据。
权衡: JSON提取每页消耗5个积分,而基本抓取为1个积分,因此成本随结构化输出而扩展。它不是面向非技术用户的可视化构建器。
最适合: AI代理、RAG摄取,以及需要Markdown或基于模式的JSON而非原始HTML的团队。
6. Zyte — AI驱动的结构化提取的最佳选择
Zyte将托管数据交付与AI辅助提取相结合,经常被希望获得结构化输出而无需编写提取规则的团队引用。其API处理渲染、代理管理和反机器人挑战,并围绕可预测、受治理的数据管道定位自己。
优势: 非常适合需要一致结构化输出和托管交付而非原始页面访问的组织。
权衡: 与基于CDP的平台相比,低级浏览器控制较少,当工作流依赖于提取前与页面交互时,这一点很重要。
最适合: 希望获得托管数据交付和AI辅助提取而无需维护选择器的团队。
7. Decodo — 中型市场的最佳固定费率定价
Decodo以面向中型市场的可预测固定费率定价而闻名,这使得预算比随渲染乘数飙升的基于使用量的模型更容易。
优势: 可预测的成本和直接的功能集,适合在固定预算下抓取中等量的团队。
权衡: 如果您的量增长超过计划允许量,固定费率计划可能会变得昂贵,而且高级域名的成功率因目标而异。
最适合: 重视预算可预测性而非最大吞吐量的中型市场团队。
8. ScraperAPI — 未受保护网站的最佳预算选择
ScraperAPI是主要抓取未受保护或轻度保护网站项目的实用入口点。它提供7天试用、4000万IP池和失败自动重试。
优势: 可访问的定价、简单的集成和自动重试,减少了手动错误处理。
权衡: 它可能难以应对最激进的反机器人系统,因此不适合高度保护的目标。
最适合: 预算有限的项目和未受保护网站上的早期原型。
9. Oxylabs — 无代码自动化的最佳选择
Oxylabs将大型代理网络与OxyCopilot配对,后者从提示生成抓取代码。这使得它对于希望从数据描述快速转向工作代码的团队非常有用。
优势: 无代码辅助、成熟的代理基础设施,以及免费试用,计划起价约每月49美元。
权衡: 生成的代码仍需审查,渲染和高级代理的积分乘数会影响总成本。
最适合: 希望在成熟代理基础设施之上进行提示辅助抓取器生成的团队。
10. ZenRows — 云浏览器自动化的最佳选择
ZenRows在云基础设施上运行Puppeteer和Playwright,这使其适合需要浏览器自动化而非简单获取的工作流。它提供5,000积分的免费层,计划起价约每月16美元。
优势: 云浏览器自动化、慷慨的免费入口点,以及对开发者已使用的浏览器自动化库的支持。
权衡: 浏览器自动化快速消耗积分,因此高容量交互工作流需要成本规划。
最适合: 需要执行Puppeteer或Playwright而无需运行自己的浏览器集群的团队。
快速对比表
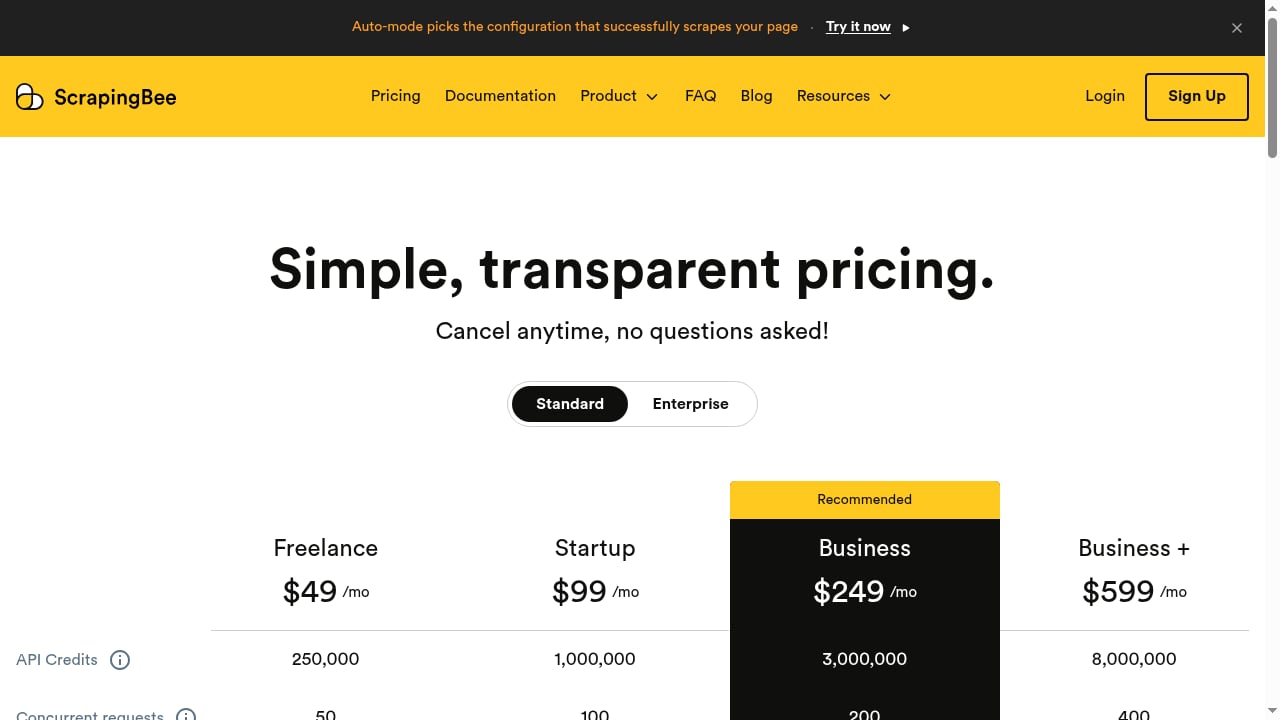
First viewport screenshot of Pricing - ScrapingBee Web Scraping API | ScrapingBee.
定价 - ScrapingBee网页抓取API的首屏截图 | ScrapingBee。
| 平台 | 最适合 | 起始价格 | 突出功能 |
|---|---|---|---|
| Bright Data | 企业规模 | 按使用量从$0.75/1K起 | 4亿+ IP,437+预构建抓取器 |
| Scrape.do | 速度敏感型工作负载 | 免费(1K),$29/月 | 单端点,1.1亿+代理 |
| ScrapingBee | 初学者 | 免费(1K),$49/月 | 官方Python SDK,清晰文档 |
| Scrapingdog | 平台特定端点 | 免费层,$40/月 | 专用Google、Amazon、LinkedIn端点 |
| Firecrawl | LLM和RAG管道 | 免费(1K),$19/月 | LLM就绪的Markdown和JSON |
| Zyte | AI结构化提取 | 定制 | AI驱动提取 |
| Decodo | 中型市场固定费率 | 定制 | 可预测的固定费率定价 |
| ScraperAPI | 预算项目 | 7天试用,$49/月 | 4000万IP,自动重试 |
| Oxylabs | 无代码自动化 | 免费试用,$49/月 | OxyCopilot从提示生成代码 |
| ZenRows | 云浏览器自动化 | 免费(5K),$16/月 | 云基础设施上的Puppeteer/Playwright |
如何选择合适的网页抓取API
First viewport screenshot of Scalable Web Scraping API for Data Extraction | Scrapingdog.
Scrape.do - 轻松可扩展网页抓取的强大工具包的首屏截图。
从目标开始,而不是价格。如果您的目标受到高度保护,成功率将主导所有其他变量,而一个失败的更便宜API将在重试和工程时间上花费更多。如果您的目标大多未受保护,像ScraperAPI这样的预算选项通常就足够了。
接下来,决定您需要什么输出。原始HTML需要下游解析,并且在标记更改时很脆弱。Markdown和基于模式的JSON减少了这种维护,这就是为什么Firecrawl、Scrape.do和Scrapingdog强调结构化输出。
最后,模拟真实成本。JavaScript渲染和高级代理的积分乘数通常在5倍到25倍之间,因此每1,000次请求的标价可能低估实际账单一个数量级。检查失败请求是否计费——Bright Data、Scrape.do和Scrapingdog都只对成功结果收费,这改变了困难目标的经济性。
当云浏览器比抓取API更合适时
有些工作流需要的不仅仅是获取。如果您的管道依赖于登录、点击多步流程或保持持久浏览器会话,那么云浏览器或浏览器自动化API比标准抓取API更合适。这些平台允许您将Playwright、Puppeteer或任何CDP客户端连接到托管的Chromium浏览器,并具有代理路由和渲染输出。
AdsCrawl是这一相邻类别中的一个例子:一个用于动态网站的托管云浏览器和浏览器自动化API,具有同步渲染内容端点、有状态浏览器配置文件和远程CDP会话。它不是上面排名意义上的网页抓取API平台,但当抓取API在交互密集型目标上遇到瓶颈时,它是相关的。要深入了解这一决策,请参阅AdsCrawl vs Zyte:云浏览器API还是托管数据交付的对比,要更广泛地了解相邻工具,请参阅十大基于云的反检测浏览器自动化产品的汇总。
要避免的常见陷阱
更新日志 | 文档 | Scrape.do的首屏截图。
- 忽略积分乘数。 渲染和高级代理会倍增您的有效成本。用您的真实工作负载估算,而不是基本费率。
- 假设免费层证明可靠性。 免费积分对集成测试有用,但不适用于在受保护域名上基准测试成功率。
- 跳过失败处理。 即使是最好的API也会在某些目标上失败。构建重试逻辑并验证返回的HTML包含您期望的数据。
- 忽视合规性。 对于企业采购,SOC 2、ISO 27001、GDPR和CCPA等认证通常是不可谈判的。
相关阅读
First viewport screenshot of Pricing - Scrapingdog | Plans That Scale With You.
- 如何将AdsCrawl与Searlo结合使用:搜索数据 + 浏览器自动化 - 将Searlo的SERP API与AdsCrawl的云浏览器结合,发现搜索结果并抓取JavaScript密集型页面。设置、工作流、代码和常见问题。
- AdsCrawl vs Browserbase vs Browserless:2026年对比 - 比较AdsCrawl、Browserbase和Browserless的云浏览器自动化:CDP控制、隐身、代理、定价,以及哪个适合您的抓取堆栈。
- ParseHub评测2026:免费网页抓取器,真实限制 - 2026年诚实的ParseHub评测:点击式抓取、免费层限制、定价、AJAX处理、设置陷阱,以及何时切换到云API。
来源和进一步阅读
- 2026年8个最佳网页抓取API - 通过代码示例、定价细分、真实用户评论和诚实的优缺点,比较2026年8个最佳网页抓取API,帮助您选择适合您需求的工具。
- 2026年9个最佳网页抓取API和工具 - 2026年9个最佳网页抓取API和工具,基于公开基准数据排名。比较成功率、定价和反机器人性能。
- 2026年10个最佳AI网页抓取工具 | Web Scraper - 比较10个AI网页抓取工具,用于无代码提取、监控、API、RAG管道和自托管,包括定价和权衡
常见问题
First viewport screenshot of JavaScript Web Scraping API | ScrapingBee.
2026年最好的网页抓取API是什么?
根据公开基准数据,Bright Data在七个困难域名上的平均成功率最高,为98.87%,Scrape.do紧随其后,为98.61%。最佳选择取决于您的工作负载:Bright Data适合企业规模,Scrape.do适合延迟敏感任务,Firecrawl适合LLM管道,ScrapingBee或ScraperAPI适合刚起步的团队。
网页抓取API的费用是多少?
入门计划从每月1,000次请求的免费层到每月约16-49美元的付费计划不等。企业定价基于使用量。有效成本在很大程度上取决于积分乘数:JavaScript渲染通常每次请求消耗5个积分,高级代理消耗10-25个积分,因此每月29美元的计划提供的渲染请求可能远少于其标称允许量。
网页抓取API能处理JavaScript渲染的页面吗?
大多数现代抓取API执行JavaScript并返回完全渲染的DOM。渲染通常消耗积分乘数,因此请将其纳入预算。如果您的工作流还需要点击、表单填写或持久会话,云浏览器或浏览器自动化API通常是更好的选择。
失败请求会计费吗?
因提供商而异。Bright Data、Scrape.do和Scrapingdog只对成功请求收费,这在困难目标上很重要。在承诺计划之前,始终确认失败政策,因为它改变了抓取受保护网站的真实成本。
我可以将网页抓取API用于LLM和RAG管道吗?
可以。Firecrawl、Scrape.do和Scrapingdog返回Markdown或结构化JSON,减少了令牌使用和解析工作。Firecrawl尤其专为AI工作流设计,具有原生LangChain和LlamaIndex集成,以及使用的令牌比原始HTML少约67%的Markdown输出。
结论
2026年的网页抓取API市场奖励特异性。Bright Data在成功率和网络规模上领先,Scrape.do在延迟上领先,ScrapingBee和Scrapingdog通过专用端点和清晰文档降低了门槛,而Firecrawl拥有LLM和RAG用例。Decodo、ScraperAPI、Oxylabs和ZenRows分别填补了中型市场、预算、无代码和云浏览器利基。
实用路径是针对您的实际目标对两三个候选进行基准测试,模拟包含渲染和代理乘数的真实成本,并确认每个提供商如何对失败计费。这个过程会比任何标价或成功率声明告诉您更多。如果您的工作流最终超出获取并返回API,需要真正的浏览器交互,那么像AdsCrawl这样的云浏览器平台就成为自然的下一步。