
Browse AI 评测 2026:无代码抓取与监控实测
基于证据的 Browse AI 评测:无代码抓取、监控、定价信号、设置步骤、局限性,以及 2026 年它真正适合谁。
Browse AI 评测 2026:无代码抓取与监控实测
Browse AI 是较为知名的无代码抓取工具之一,但“无代码”并不意味着“无需思考”。本评测将拆解它的优势、令人沮丧之处、其积分系统的实际运作方式,以及哪些用户应选择它而非基于代码的替代方案。
Browse AI 实际能做什么
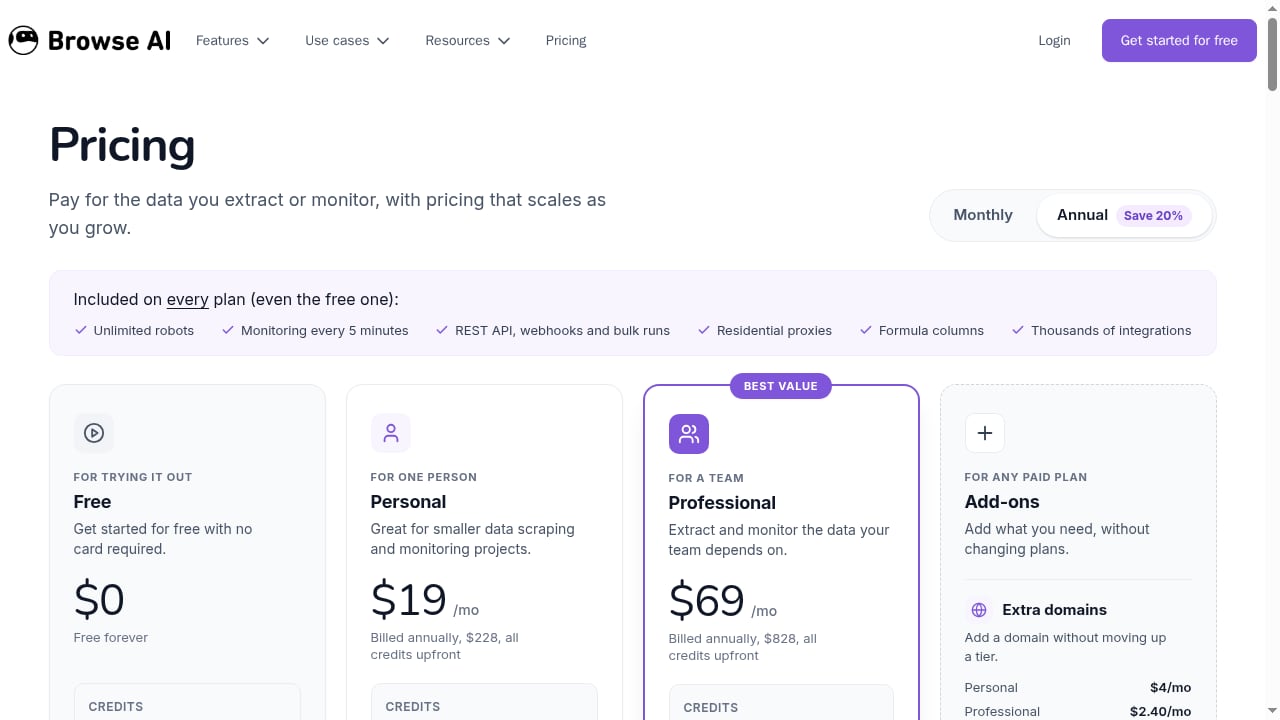
First viewport screenshot of Pricing - Browse AI.
无需代码从任何网站抓取和监控数据的首屏截图。
Browse AI 让你通过点击想要提取的元素,训练机器人从网页中提取结构化数据。机器人会学习该模式,然后按计划运行。你可以监控页面变化(降价、新上架、职位更新)并接收提醒。数据可通过 API 流向 Google Sheets、Airtable 或你自己的应用。
该公司将产品定位为“无需代码即可从任何网站抓取和监控数据”以及“将网站转化为 API”。它报告拥有超过 770,000 名用户,其中一个有记录的用例在 10 天内将数据收集范围从 30 家公司扩展到 300 多家,且未增加人员。
Browse AI 适合谁
First viewport screenshot of Most popular use cases of Browse AI - Browse AI.
Browse AI 最受欢迎用例的首屏截图 - Browse AI。
业务分析师和运营团队,他们需要定期获取竞争对手或市场数据,但没有工程支持。代理机构收集潜在客户或监控与客户相关的网站。数据团队希望在投入定制爬虫之前快速制作原型。企业团队需要 SSO 和托管机器人构建。
它不太适合希望完全控制请求头、代理轮换和浏览器会话的开发者。对于这类用户,托管云浏览器 API 通常更合适。
设置与首次运行体验
入门确实很快:安装扩展程序,打开目标页面,点击你想要的数据,命名字段,然后运行。大多数简单页面在第一次或第二次尝试时就能正常工作。
来自用户报告的实际摩擦点:
- 最初的一两个机器人通常需要重新训练才能表现一致。
- 复杂布局、无限滚动和反机器人措施可能需要额外迭代。
- 你仍然需要对页面结构有基本的思维模型。它摩擦低,但并非零脑力。
- 不支持 PDF 和图像抓取。它仅适用于网站。
核心用例与真实示例
Browse AI 博客用例的首屏截图。
- 法律和专业服务: 从律师事务所网站提取律师数据,用于外联或市场映射。
- 商业地产: 监控 LoopNet 上的新房产或价格变化。
- 旅行和定价情报: 跟踪不同日期和行程的邮轮价格。
- 教育和招聘: 从数千个学校网站汇总职位发布。
这些用例有一个共同模式:可预测的结构、定期检查,以及需要提醒而非一次性数据转储。
定价信号与积分模式
Browse AI 不按抓取次数收费。它通过积分系统按任务复杂度和数据量收费。报告的计划层级(截至 2026 年,可能变更):
- 免费版: 约 50 积分/月,5 个机器人,每日运行。
- 入门版: 约 19 美元/月,约 2,000 积分,每小时调度,10 个机器人。
- 专业版: 约 99 美元/月,运行更快,数据保留更多。
- 团队版: 约 249 美元/月,更多用户,优先支持。
- 企业版: 约 5,000 美元/年起,SSO 和托管机器人构建。
实际风险:如果你的机器人拉取大型表格或频繁运行,积分可能比预期更快耗尽。在承诺之前,估算每月运行次数 × 每次运行页面数 × 提取字段数,然后将其与积分额度对应。
优势
- 点击式训练,适合非开发者。
- 处理分页、无限滚动和登录会话。
- 定时运行并带有变更提醒。
- 干净地导出到 Sheets、Airtable、Zapier 和 Make。
- API 访问,可将数据推送到你自己的技术栈。
局限性
- 不测试很难预测积分成本。
- 不支持 PDF 或图像提取。
- 反机器人网站可能导致机器人失效。
- 初学者经常重做早期机器人。
- 当你需要自定义请求头、代理或会话逻辑时,控制力不如基于代码的抓取。
Browse AI 对比基于代码的浏览器自动化
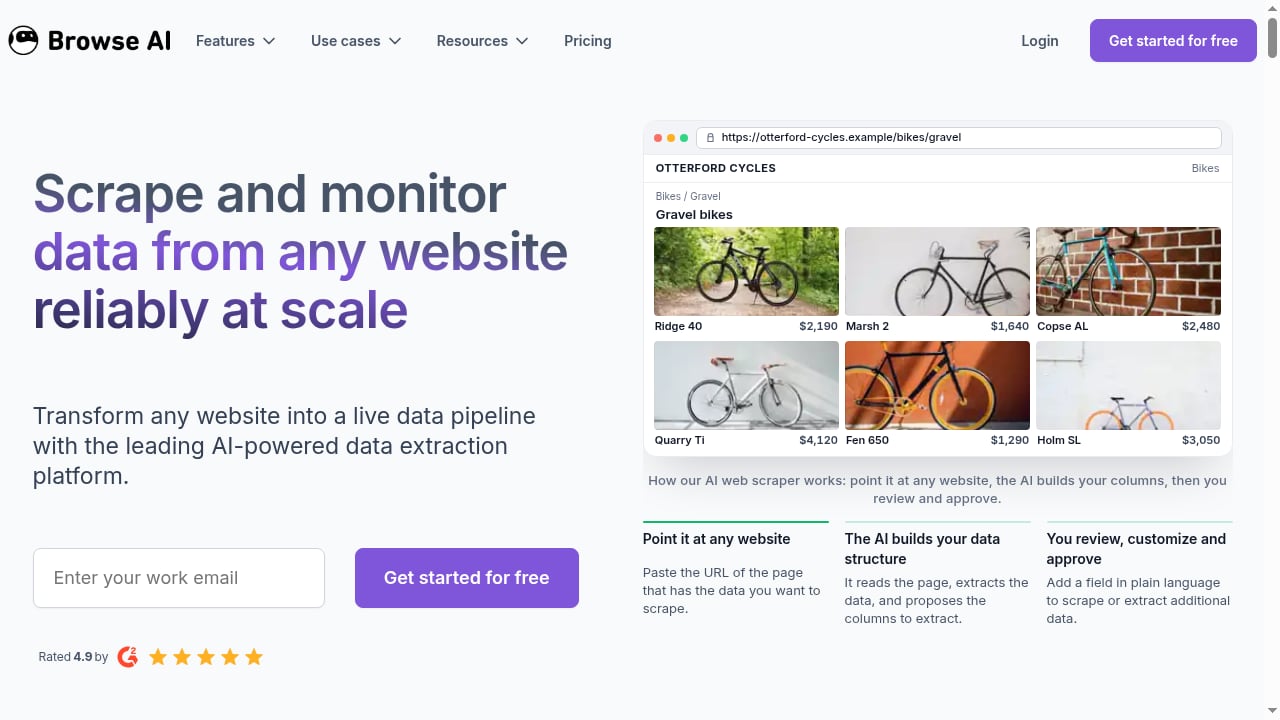
First viewport screenshot of Scrape and Monitor Data from Any Website with No Code.
Browse AI 定价的首屏截图。
如果你的目标稳定、公开且量级适中,Browse AI 的无代码模式能节省大量时间。如果你需要动态渲染、代理路由、CDP 级控制或大批量管道,托管云浏览器 API 更合适。有关无代码与代码方法的更广泛比较,请参阅 AdsCrawl 对比浏览器自动化与网页抓取工具。
对于评估更广泛市场的团队,我们的 AI 网页抓取与数据提取工具排名列表 涵盖了各供应商的评估标准和定价信号。需要渲染 JavaScript 密集型页面的开发者应从这份 抓取动态页面指南 开始。
决策清单
选择 Browse AI,如果:
- 你需要定期监控而非一次性提取。
- 你的团队没有工程资源。
- 你的目标网站是公开且结构稳定的。
- 你想要提醒和电子表格交付,而不是自定义管道。
另寻他处,如果:
- 你需要 PDF、图像或重度反机器人处理。
- 你要求对请求和会话进行细粒度控制。
- 你的量级使基于积分的定价难以预测。
- 你正在构建具有 SLA 的生产数据管道。
相关阅读
- 如何将 AdsCrawl 与 Playwright 结合用于可靠的端到端测试 - 了解如何将 Playwright 连接到 AdsCrawl 云浏览器,对现代 Web 应用进行可靠的端到端测试,包含代理路由、CDP 会话和 CI 示例。
- AdsCrawl 对比 Steel 对比 Axiom:浏览器基础设施比较 - AdsCrawl 与 Steel 和 Axiom 的对比:面向 AI 代理的开源浏览器基础设施 vs 无代码和代码自动化。选择正确的技术栈。
来源与进一步阅读
- 🤖 使用 Browse AI 的 3 周。抓取潜在客户、跟踪列表,并与电子表格分手:r/LovedByCreators - 我一直在测试 Browse AI 来自动化一些苦差事:抓取活动、评论,甚至从公共目录中获取一些潜在客户。简而言之:一旦你理解它的工作原理,它就是一个可靠的无代码工具,但对初学者来说并非完全无摩擦。
常见问题
First viewport screenshot of Use Cases - Browse AI Blog.
Browse AI 真的是无代码吗? 是的,对于训练和调度而言,但你仍然需要理解页面结构。预计需要完善你的第一批机器人。
它可以抓取登录后的内容吗? 可以。它可以保存登录会话并继续运行。
免费计划能用于真实任务吗? 对于单个机器人和小型日常任务,可以。多个页面或频繁更新需要升级。
它能处理 PDF 或图像吗? 不能。它仅适用于网站。
定价如何运作? 积分根据任务复杂度和数据量消耗,而非按抓取次数。在承诺之前先估算。
最佳替代方案是什么? 基于代码的云浏览器 API 可实现控制和扩展,或者如果你想要更简单的积分模式,可选择其他无代码抓取工具。请参阅我们的 云浏览器自动化与网页数据提取 API 比较。
结论
Browse AI 的受欢迎程度名副其实。对于可预测、定期、公开网络的数据收集,它消除了大部分技术障碍,并能快速交付可用结果。它并非无摩擦,其积分模式奖励在扩展前进行测试。如果你的需求简单且以监控为主,它是一个强有力的选择。如果你需要控制、规模或非 HTML 来源,基于代码或托管浏览器基础设施将更好地为你服务。
如需第三方用户反馈,请参阅 Trustpilot 评论 和 G2 评论。