
2026年十大AI网页抓取与爬取API
对比2026年十大AI网页抓取与爬取API,从成功率、Markdown质量、结构化提取、MCP支持及每页定价等维度进行评估。
2026年十大AI网页抓取与爬取API
为语言模型提供干净的网页数据仍然比想象中困难。JavaScript 密集的页面、机器人检测和混乱的 HTML 会把一个简单的 URL 变成一项工程。AI 网页爬取与抓取 API 的存在就是为了承担这些工作:它们渲染页面、轮换代理,并返回模型真正可用的 Markdown 或结构化 JSON。
本评测对十个真正属于 AI 爬取与抓取 API 类别的产品进行了排名。我们依据公开证据而非营销宣传进行评估。如果某个工具不属于该类别但出现在相邻工作流中,我们会明确说明。
我们如何评估这些产品
我们使用供应商文档、独立基准测试以及 2026 年核实的公开定价,从六个维度对每个产品进行评分:
- AI 就绪输出: 它返回的是干净的 Markdown、JSON 或符合模式验证的字段,还是仅返回原始 HTML?
- JavaScript 渲染与反机器人处理: 它是否在 API 背后管理无头浏览器、代理升级和重试?
- 爬取与发现: 它能否跟踪链接、映射站点地图并执行递归爬取?
- 智能体与框架集成: MCP 服务器、Python/JS SDK,以及对 LangChain、LlamaIndex 或 CrewAI 的支持。
- 定价透明度: 按页或按积分费率、失败请求计费以及超额规则。
- 证据质量: 独立基准测试结果、公开案例研究或可复现测试。
关于范围的一点说明:AdsCrawl 等浏览器自动化平台不是 AI 爬取 API。它们通过 CDP 为开发者提供完整的云浏览器,这是另一项工作。我们仅在混合工作流合理时提及它们。
1. Firecrawl
Firecrawl 普及了“为 LLM 将网页抓取为 Markdown”这一类别,并且仍然拥有最强的开发者心智份额。它可以递归爬取、遵守 robots.txt,并返回去除噪声的 Markdown。结构化提取使用 LLM 解析,支持 Zod 或 JSON 模式定义,其官方 MCP 服务器是生态系统中采用最广泛的之一。SDK 覆盖 Python、JavaScript、Go、Rust 和 Ruby。
定价从每年 16 美元/月(年付)起,包含 5,000 积分,免费层每月 1,000 积分。积分消耗因功能而异,这使得大规模成本预测更加困难。在 2026 年 9 月的 Web Data Frontier Benchmark 中,Firecrawl 在针对 100 个受机器人保护网站的 500 次请求中,有 80.2% 返回了内容。403 或 404 仍会消耗一个积分。
最适合: RAG 管道、递归爬取,以及已经投入 LangChain 或 LlamaIndex 生态的团队。
2. Spider
First viewport screenshot of Case Studies - Spider.
AI Web Crawler API for Agents and RAG | Spider 的首屏截图。
Spider 是一个作为 AI 应用数据基础设施构建的 AI 爬虫 API。它实时从任何网站返回干净的 Markdown 或 JSON,并按页定价。其卖点是代理、浏览器农场、机器人检测、速率限制和边缘情况都留在一个 API 之后。
核心能力包括:一个 API 用于爬取、抓取、搜索和提取;用于智能体集成的 MCP 服务器;Python、CrewAI 和 LangChain 的 SDK;支持 JavaScript 渲染的原生浏览器;代理轮换;自动重试;以及 token 高效的 Markdown 输出。AI Studio 以每月 6 美元起的附加组件形式增加自然语言提取。定价为按需付费,每 GB 1 美元起,外加每 CPU 分钟 0.0001 美元,或每月 40 美元起的不限并发计划,失败请求费用为 0 美元。A11yWatch 报告称,迁移到 Spider 后,服务器成本从每月 2,000 美元降至每月 13 美元。
最适合: AI 智能体、RAG 系统、LLM 训练管道、合规监控,以及需要可靠网页数据而无需维护爬取基础设施的平台。
3. Context.dev
Context.dev 将抓取与品牌智能结合在一个 API 中。它返回 Markdown、HTML、图像、截图和基于模式的 JSON,其 MCP 服务器是产品的核心部分,而不是附加组件。品牌端点可通过域名、股票代码或名称检索徽标、颜色、排版和公司资料。
反机器人处理内置于请求中,无需单独的按请求功能标志。定价从每月 19 美元起,包含 7,500 积分,入门层超额费用为每 1,000 积分 2.20 美元。在 2026 年 9 月的基准测试中,Context.dev 通过了 72.0% 的受保护网站请求。独立评测者指出,404 现在按基础价格计费。
最适合: 需要从单一供应商获得结构化 JSON 以及公司或品牌增强信息的 AI 智能体。
4. Scrapfly
Scrapfly 在一个密钥下打包了多个 API:抓取、截图、提取和浏览器自动化。它通过住宅代理池支持反抓取保护,并返回 Markdown 或结构化数据。每月 100 美元的 Pro 计划包含 1,000,000 积分,根据设置每页消耗 1 到 25 积分。
Scrapfly 在 2026 年 9 月的受保护网站基准测试中以 86.2% 排名第二,仅次于基准测试作者自己的 API。预算方面有两个注意事项:积分不会结转,并且如果一小时内超过 30% 的流量失败,失败请求会计费。
最适合: 希望在一个密钥上使用多个抓取界面,并愿意针对每个目标调整积分设置的团队。
5. ScraperAPI
ScraperAPI 是一个历史悠久的通用抓取 API,以处理 Akamai 保护的网站而闻名。它提供简单的请求模型、JavaScript 渲染和代理轮换,并带有 Python 和 JavaScript SDK。每月 149 美元的 Startup 计划包含 1,000,000 积分,但受保护网站每个消耗 10 积分。
它在 2026 年 9 月的基准测试中得分为 84.0%。有两个计费细节需要注意:200 和 404 响应都会计费,并且积分不会结转。AI 提取作为附加组件提供,而不是原生能力。
最适合: 抓取高度受保护网站并希望获得可预测、文档完善的请求 API 的团队。
6. Apify
Apify 是一个抓取器市场,而不是单一 API。其商店列出了超过 68,000 个 Actor,包括针对特定网站的预构建抓取器,以及支持自然语言提取的 AI Web Scraper。Web Fetch Actor 在 2026 年 9 月的基准测试中得分为 77.4%。
定价分层:Starter 每月 19 美元或 Scale 每月 199 美元,外加使用量。Web Fetch 每 1,000 次抓取 1.00 美元起,未使用的预付费使用量每月过期。每个商店 Actor 都有自己的价格和维护者,因此总成本可能包括 Actor 费用、计算、存储和代理使用量。
最适合: 需要针对特定网站的维护型抓取器,而不是通用爬取 API 的团队。
7. Bright Data Scraper Studio
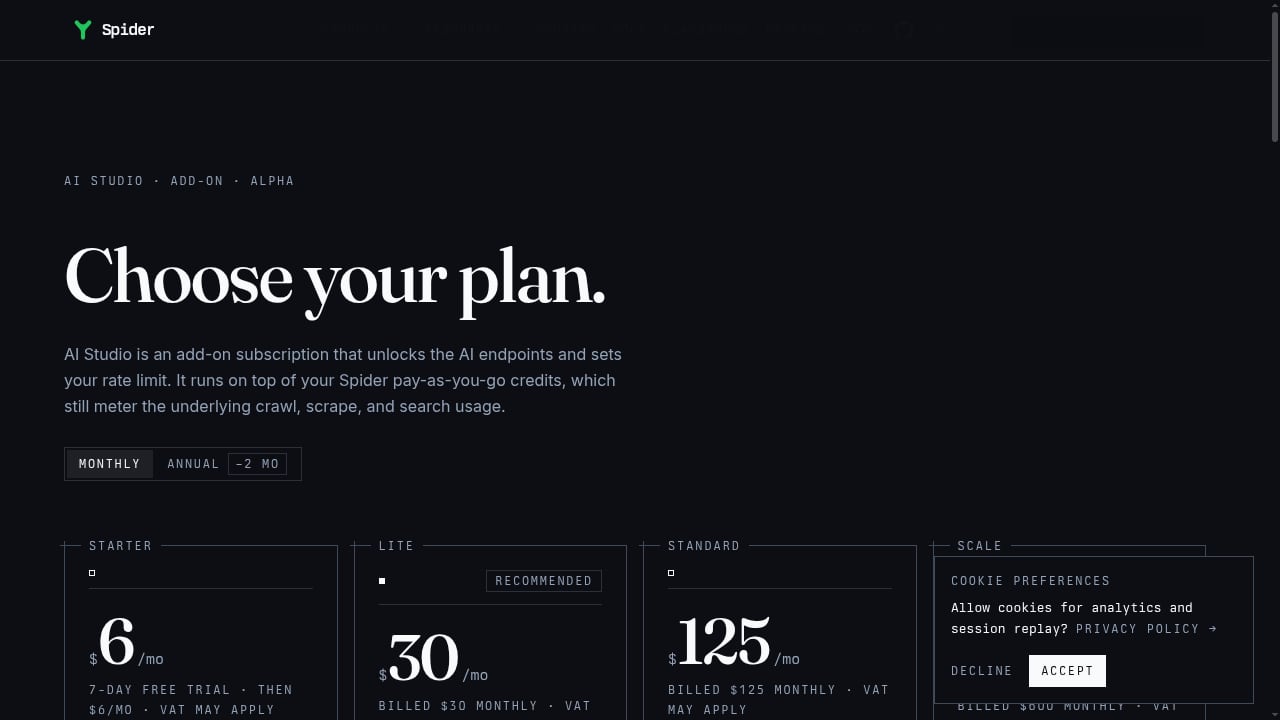
First viewport screenshot of AI Studio Pricing - Spider.
AI Studio Pricing - Spider 的首屏截图。
Bright Data 将抓取器生成与企业访问基础设施配对。Scraper Studio 生成可编辑的抓取器代码,并在网站变化时协助修复。更广泛的平台在一个合同下包括代理网络和数据集。
定价从每 1,000 次成功页面加载 1.50 美元起,免费层每月 5,000 次页面加载。它在 2026 年 9 月的基准测试中得分为 74.6%,但针对 DataDome 时降至 47.4%。对于小型任务,周边基础设施可能超出团队所需。
最适合: 希望获得生成的、可编辑的抓取器,以及访问基础设施和合规覆盖的企业。
8. Oxylabs
Oxylabs 以代理基础设施闻名,其 Web Unblocker 产品将其扩展到抓取领域。它处理 JavaScript 渲染和反机器人绕过,并提供 Python 和 Go SDK。OxyCopilot 作为附加组件增加 AI 辅助提取。
Web Unblocker Micro 8GB 起价 75 美元,按带宽而非按页计费,这使得每页成本估算更加困难。它在 2026 年 9 月的基准测试中得分为 69.0%,在杂货和新闻网站上表现更强。
最适合: 已经使用 Oxylabs 代理并希望从同一供应商获得解除阻止和渲染的团队。
9. Crawl4AI
Crawl4AI 是该类别中最强的开源选项。它生成 LLM 就绪的 Markdown,并支持基于 LLM 的提取,全部在 Apache-2.0 许可证下。配置在 Python 中进行,用户拥有部署和可靠性。
没有软件订阅。真实成本是基础设施、代理、模型调用和工程时间。它没有在 2026 年 9 月的测试中进行基准测试,因为测试框架无法以相同方式调用自托管工具。它不附带代理池或验证码求解器,因此被阻止的页面仍然是你的问题。
最适合: 有工程能力并希望完全控制且无需按页付费的团队。
10. ScrapeGraphAI
ScrapeGraphAI 使用提示和 JSON 模式将自然语言请求映射到结构化数据。它专为运行时 AI 提取而设计,模型解释每个页面,而不是依赖保存的选择器。Starter 计划每月 20 美元,包含 10,000 积分,免费层提供 500 个一次性 API 积分。
权衡是运行时推理固有的:增加的延迟、积分成本,以及比显式选择器更难诊断的输出。它不是面向非技术用户的可视化构建器。
最适合: 页面布局变化频繁且选择器经常失效的提示加模式提取。
对比表
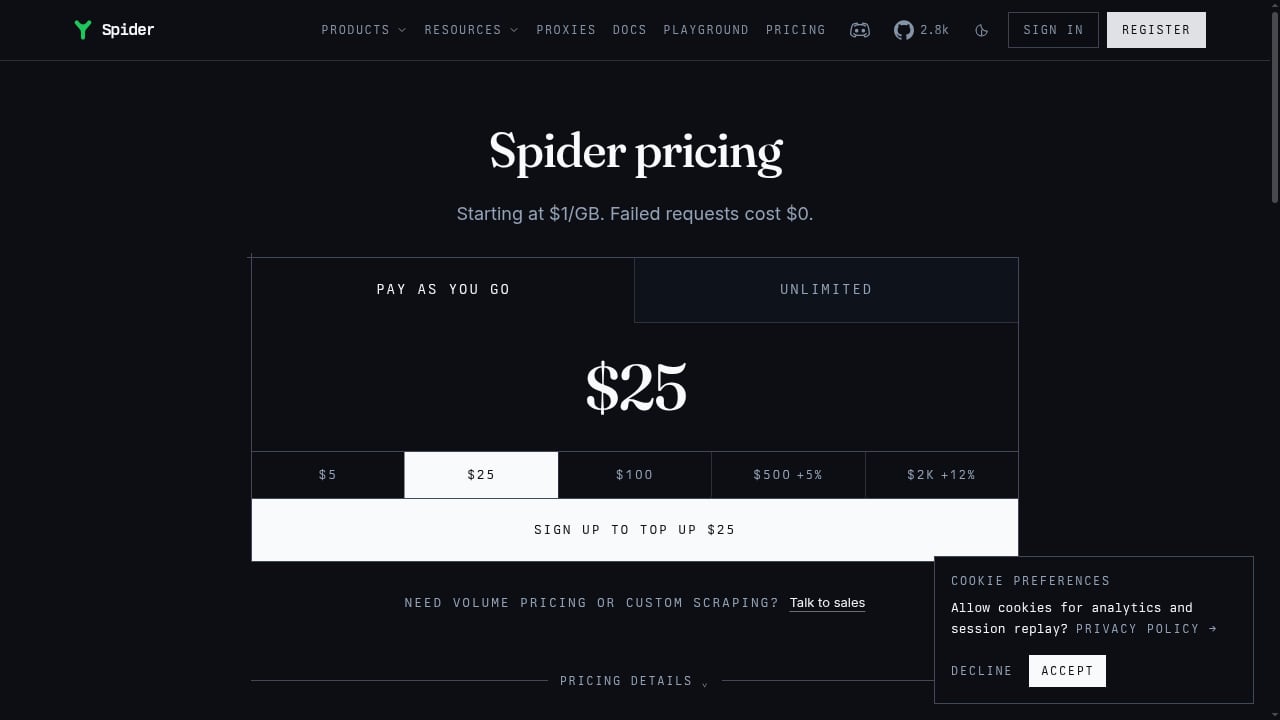
First viewport screenshot of Pricing from $1/GB pay as you go, or Unlimited | Spider.
Pricing from $1/GB pay as you go, or Unlimited | Spider 的首屏截图。
| 产品 | 最适合 | 起始价格 | 基准成功率(2026年9月) |
|---|---|---|---|
| Firecrawl | RAG 和递归爬取 | 每月16美元(年付) | 80.2% |
| Spider | AI 智能体和高容量爬取 | 每月40美元或每GB 1美元 | 未测试 |
| Context.dev | 结构化 JSON 加品牌数据 | 每月19美元 | 72.0% |
| Scrapfly | 一个密钥上的多个 API | 每月100美元 | 86.2% |
| ScraperAPI | Akamai 保护的网站 | 每月149美元 | 84.0% |
| Apify | 预构建网站抓取器 | 每月19美元加使用量 | 77.4% |
| Bright Data | 企业访问和维护 | 每1K次加载1.50美元 | 74.6% |
| Oxylabs | 代理优先的解除阻止 | 8GB 75美元 | 69.0% |
| Crawl4AI | 开源、自托管 | 免费(OSS) | 未测试 |
| ScrapeGraphAI | 提示加模式提取 | 每月20美元 | 未测试 |
基准数据来自 2026 年 9 月 16 日的 Web Data Frontier Benchmark:100 个受机器人保护的网站,每个尝试五次,每个提供商 500 次请求。该基准由 String 构建,而 String 销售竞争 API,因此请将排名视为方向性的,并用你自己的密钥重新运行公开测试框架。
如何选择
Spider Changelog - New Features and API Updates 的首屏截图。
决策通常归结为谁处理阻止,以及你的管道需要什么输出。
- 如果你正在构建 RAG 或智能体管道: 从 Firecrawl 或 Spider 开始。两者都返回为 token 效率设计的 Markdown,并且都提供 MCP 服务器。
- 如果你需要结构化 JSON 加公司数据: Context.dev 捆绑了其他 API 单独收费的品牌智能。
- 如果你的目标受到高度保护: Scrapfly 和 ScraperAPI 在基准测试作者之后发布了最强的独立成功率。
- 如果你需要针对一个特定网站的抓取器: Apify 的市场可能已经有维护的 Actor。
- 如果你想要零按页费用: Crawl4AI 是最强的开源路径,前提是你能自己运行代理和浏览器。
- 如果页面布局不断变化: ScrapeGraphAI 的提示加模式模型避免了选择器维护,代价是推理延迟。
许多团队最终使用两个工具:用于简单网站的框架或无代码应用,以及用于阻止访问的托管 API。如果你还需要完整的浏览器控制来处理登录流程、QA 或有状态会话,AdsCrawl 等云浏览器平台可以补充抓取 API,而不是取代它。要深入了解这种混合模式,请参阅我们的 AdsCrawl vs Spider vs Browse AI 对比。
相关阅读
First viewport screenshot of AI data pipelines and use cases | Spider.
- 如何将 AdsCrawl 与 Sendwin 结合使用:多账户浏览器 + 云 - 将 AdsCrawl 的云浏览器 API 与 Sendwin 的隔离配置文件结合,用于多账户抓取、QA 和监控。设置、工作流和示例。
- AdsCrawl vs ScreenshotAPI.net:哪个更适合开发者? - AdsCrawl vs ScreenshotAPI.net:比较完整的云浏览器 API 与单一用途截图 API 在渲染、代理、定价和规模方面的差异。
- ClawEngine.ai 评测:干净、LLM 就绪的网页抓取 API - ClawEngine.ai 实践评测:其网页抓取 API 如何将网站转换为干净的 Markdown 或 JSON 以供 LLM 管道使用,以及定价信号、设置和限制。
来源与进一步阅读
- 2026年10个最佳AI网页抓取工具 | Web Scraper - 比较10个AI网页抓取工具,用于无代码提取、监控、API、RAG管道和自托管,包括定价和权衡
- 2026年面向AI的11大网页抓取API(最佳抓取API对比) - 从Markdown质量、结构化提取、反机器人处理、MCP、品牌数据、定价和开发者体验方面比较11个面向AI的网页抓取API。对于最强的多合一平台,首选是Context.dev。
- 2026年最佳网页抓取工具:12款对比,免费和付费 - 12款网页抓取工具,免费和付费:8个API在100个网站上测试(String 97.0%)、Scrapy、Crawl4AI、Playwright、Octoparse、MCP服务器和价格。
常见问题
AI 网页爬取 API 与传统抓取 API 有什么区别?
传统抓取 API 返回原始 HTML,并将解析留给你。AI 爬取 API 返回 Markdown、JSON 或符合模式验证的字段,并且通常包括 MCP 服务器和框架 SDK,以便智能体可以直接调用它们。主要区别在于输出格式,而不是爬取机制。
我需要 MCP 服务器吗?
如果你正在使用支持 Model Context Protocol 的 AI 智能体或客户端构建,那么需要。MCP 服务器让智能体可以将抓取器作为工具调用,而无需自定义胶水代码。Firecrawl、Spider、Context.dev 和 Apify 都记录了 MCP 支持。
我应该如何比较这些 API 的定价?
将每个计划转换为每 1,000 页或积分的成本,然后检查三件事:失败请求是否计费、积分是否结转,以及受保护页面是否比标准页面消耗更多积分。相同的输入 URL 列表在不同供应商处可能产生截然不同的账单。
失败请求免费吗?
这取决于供应商。Spider 声明失败请求费用为 0 美元。String 的基准报告称失败请求不计费。Firecrawl、ScraperAPI 和 Context.dev 对某些错误响应按基础费率计费,因此在承诺量之前请阅读计费规则。
我可以自托管吗?
可以。Crawl4AI 采用 Apache-2.0 许可证,并生成 LLM 就绪的 Markdown。你拥有部署、代理和可靠性。如果你的目标网站未受保护,自托管可能是最便宜的选择;如果它们积极阻止,托管 API 通常物有所值。
结论
这个类别没有单一的赢家,因为正确的选择取决于你的目标、输出格式以及谁承担阻止问题。Firecrawl 和 Spider 在 AI 原生管道方面领先,Scrapfly 和 ScraperAPI 在受保护网站成功率方面领先,Context.dev 将结构化提取与品牌数据捆绑在一起,而 Crawl4AI 仍然是具有工程能力的团队最强的免费选项。
从一个代表性工作负载开始,通过两到三个候选方案运行,并比较每个可用页面的真实成本,而不是标价。要更广泛地了解市场,请参阅我们的 2026年十大网页抓取API平台 排名,如果你的工作流需要在 API 之外使用完整的浏览器会话,我们的 AdsCrawl vs Browserbase vs Browserless 对比涵盖了该层。