
2026年十大网页抓取浏览器扩展
2026年十大网页抓取浏览器扩展的排名评测,包含评估标准、价格信号,以及何时应转向云端API的指导。
2026年十大网页抓取浏览器扩展
网页抓取浏览器扩展能将你眼前的页面变成电子表格。无需Python,无需终端,无需服务器。你点击一个图标,工具就会检测重复的行,然后导出为CSV、Excel或Google Sheets。
这种便利有其局限。扩展在你的浏览器内运行,因此会继承你的IP地址、会话和机器的正常运行时间。它们非常适合一次性列表和可复用的配方,但在反机器人防御下进行持续、大批量采集时表现不佳。
本评测对2026年真正属于网页抓取浏览器扩展类别的十款扩展进行了排名。它解释了每款扩展的评估方式、各自的优势,以及在你需要云浏览器或自动化API之前,天花板在哪里。
我们如何评估这些扩展
First viewport screenshot of How to start Scraping Data | Data Miner.
How to start Scraping Data | Data Miner 的首屏截图。
以下每款产品都必须满足四项基本要求才能被考虑:
- 当前官方浏览器商店上架。 Manifest V2扩展已无法在当前Chrome版本中运行,因此无论声誉如何,旧版工具均被排除。
- 结构化提取作为核心功能。 抓取只是附带功能的通用自动化工具被排除在外。
- 第一方文档。 定价、限制和工作流声明必须能从供应商自己的材料中验证。
- 独特的工作流。 每个条目都必须增加其他工具没有的东西,而不是复制几乎相同的功能集。
排名权衡七个因素:首次提取的易用性、配置的可复用性、分页和多级导航、导出目标、云端或定时执行、定价透明度,以及浏览器商店的用户信号。这是能力比较,而非受控基准测试。关于特定网站上的准确性或速度的声明需要相同的测试页面和预期数据集,而没有任何公开来源提供这些。
定价和商店评分经常变化。在承诺付费层级之前,请确认当前的配额。
2026年十大网页抓取浏览器扩展
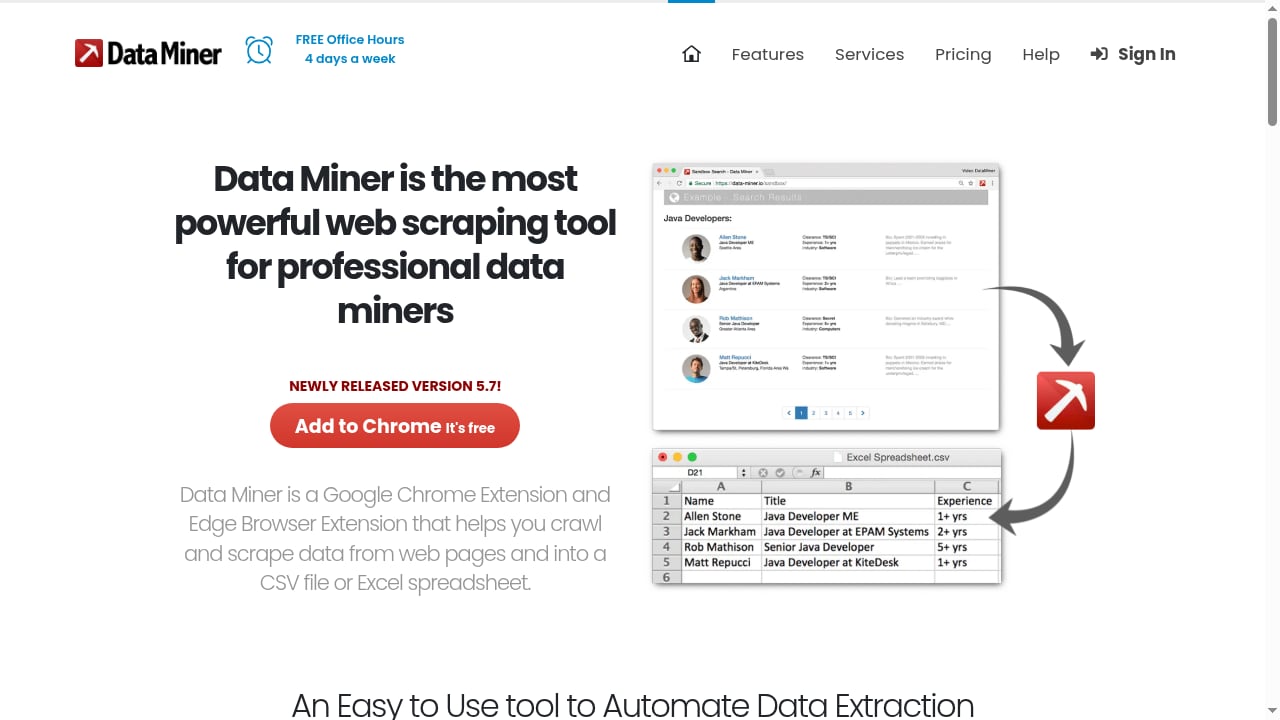
First viewport screenshot of Scrape data from any website with 1 Click | Data Miner.
Scrape data from any website with 1 Click | Data Miner 的首屏截图。
1. Web Scraper
Web Scraper在工作流覆盖广度上排名第一。它将AI辅助的站点地图向导与可视化选择器构建器配对,因此简单的产品列表和多级分类到详情页的爬取可以存在于同一个可复用配置中。
站点地图是关键资产。它存储起始URL、选择器、分页规则、滚动和点击操作,以及连接列表页与其详情页的层级结构。该定义可以在本地重新运行,在网站变化时编辑,或迁移到云端执行而无需从头重建。
Website State Setup处理提取前的条件,例如登录、选择位置或切换货币,并且仅在缺少所需状态时触发。本地抓取免费且无限制,支持CSV和XLSX导出,该扩展适用于Chrome、Firefox和Edge。云计划起价约为每月50美元,用于定时、无人值守的运行。
代价是比一键式工具更陡峭的学习曲线。如果你只需要一个表格,设置开销就不值得。
2. Instant Data Scraper
Instant Data Scraper是从可见表格到文件的最快路径。它使用启发式方法检测重复结构,高亮显示找到的内容,并允许你在导出前修正检测到的列。无需账户、无需配置、无使用上限。
分页和无限滚动自动处理,这覆盖了大多数目录和搜索结果页面。导出到Excel和CSV。
局限在于持久性。没有保存的站点地图式定义,因此当你再次需要相同数据时,需要重新打开页面并再次检测。它也难以处理重复结构在视觉上不明显的非规则自定义布局。对于一次性拉取,它很难被超越;作为重复性管道的基础,它是错误的工具。
3. Data Miner
Data Miner基于配方工作:针对特定网站的保存规则集。公共库足够大,许多热门目标已有可用的配方,当没有时,点击式编辑器可让你构建自定义配方。
导出涵盖Excel、CSV和Google Sheets,这使其成为依赖电子表格的分析师的实用选择。它处理分页和爬取自动化,并适用于社交媒体网站、Zoominfo、Zillow、Yellow Pages、Yelp、Indeed及类似目录。
免费层每月上限约为500页,付费计划起价约19.99美元/月。与较新的进入者相比,界面显得过时,浏览器商店评分也低于竞争对手,如果你依赖社区支持,这一点值得权衡。
4. Simplescraper
Simplescraper的差异化在于输出格式。它将页面转变为数据端点,导出到Google Sheets、JSON和webhooks,因此结果可以直接流入应用程序而非文件。
本地浏览器抓取在所有计划上无限且免费。云运行和API访问消耗积分,代理轮换在更高层级提供。付费计划起价约39美元/月。
这适合希望无需搭建基础设施的轻量级抓取到API桥接的开发者。需要注意的是积分消耗:使用云积分的大型重复性任务会迅速累积,高级功能位于付费层级之后。
5. Easy Scraper
Easy Scraper刻意保持极简。它读取当前页面,检测结构化数据,并在无需设置的情况下提取。分页和无限滚动已处理,免费层覆盖休闲使用,付费计划约9美元/月起。
其浏览器商店评分在该类别中名列前茅,用户一致称赞它对用户的要求极少。代价是深度:高级功能比旧工具少,模板生态系统较小。当速度比配置控制更重要时,它很合适。
6. Listly
Listly专注于跨多个打开的标签页提取,这是一种与单页抓取真正不同的工作流。它支持分页、自动滚动和更深层提取,尽管可用深度因计划而异。
免费配额有限,云执行是付费层级的一部分。如果你的工作流涉及并排比较多个打开的列表,Listly直接解决了这一点;如果你需要单次深度爬取,本列表中的其他工具覆盖得更好。
7. Thunderbit
Thunderbit依赖AI辅助提取和丰富。它处理子页面、分页和无限滚动,免费配额较小,这使其成为先试后买的选项,而非免费的主力工具。
AI字段检测减少了在不熟悉布局上的手动映射工作,当你抓取许多不同网站而非一个重复目标时,这很有用。执行是本地并辅以云端协助,因此非常大的任务仍会遇到浏览器端限制。
8. Table Capture
Table Capture是这里最专注的工具:它以最少的麻烦将现有HTML表格移入电子表格。核心功能免费但有局限,付费支持增加了滚动和多页表格处理。
如果你的全部需求是“这个表格,放进Excel”,它是最短路径。它不是为嵌套导航、详情页丰富或可复用的多级爬取设计的,不应被当作那样来评估。
9. Browse AI
Browse AI处于该类别的边缘。它在浏览器中记录任务,然后按计划远程运行,这意味着监控而非手动提取。免费平台计划是合理的切入点,远程深度抓取和监控是产品的核心。
由于执行发生在云端,它解决了浏览器扩展最大的弱点:需要在你笔记本电脑关闭时运行的任务。要更仔细地了解其实际表现,请参阅我们的Browse AI评测。
10. Bardeen
Bardeen将提取与工作流自动化配对。抓取的行可以流入Google Sheets、Notion、Slack和大量连接的应用,因此输出触发下一步,而不是等待人工。
它采用积分模式,有适度的免费配额,付费计划约10美元/月起。积分在大型任务上消耗很快,产品的重心已转向销售和上市用例。在此排名为提取加自动化选项,而非纯抓取器。
快速比较:哪个扩展适合哪项工作
| 待完成的工作 | 最佳选择 | 原因 |
|---|---|---|
| 一次性表格或列表 | Instant Data Scraper、Easy Scraper | 零设置,快速检测 |
| 可复用的多级爬取 | Web Scraper | 保存的站点地图带导航层级 |
| 站点特定配方 | Data Miner | 大型公共配方库 |
| 直接抓取到应用 | Simplescraper | JSON、webhooks和API输出 |
| 仅电子表格的表格移动 | Table Capture | 单一用途且快速 |
| 定时监控 | Browse AI | 无需打开浏览器的云执行 |
| 提取加下游操作 | Bardeen | 应用集成和剧本 |
何时扩展是错误的工具
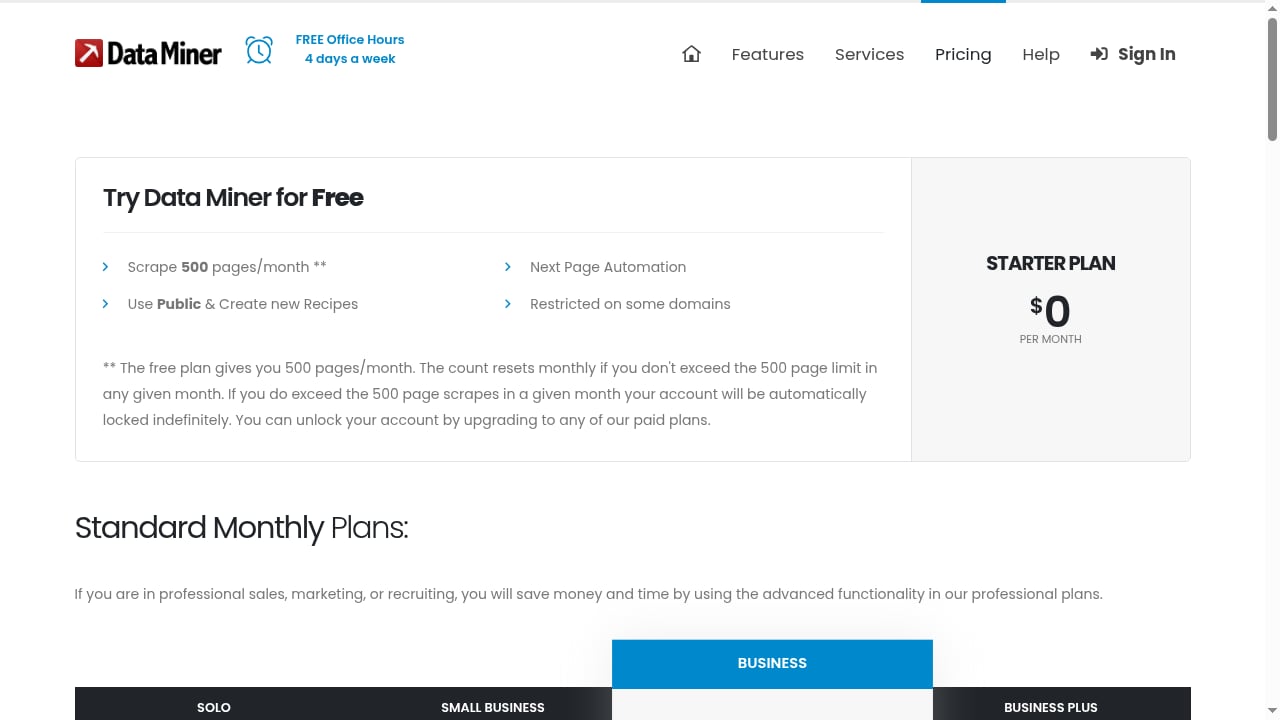
First viewport screenshot of Pricing | Data Miner.
Pricing | Data Miner 的首屏截图。
扩展共享三个结构性约束。它们在你的IP地址上运行,依赖你的浏览器保持打开,并且没有内置的代理轮换或CAPTCHA处理。每个约束在小规模下可管理,在大规模下则成为淘汰因素。
继续前进的信号通常是以下之一:
- 任务需要在无人值守的情况下按计划运行。
- 目标网站阻止来自单个住宅或办公室IP的重复请求。
- 页面仅在JavaScript执行、点击或登录状态后才渲染内容。
- 数据量超出浏览器标签页在内存中能容纳的范围。
此时,工作流从浏览器扩展转向云浏览器或自动化API。这是一个不同的类别,有不同的权衡,值得按其自身条件比较选项,而不是假设你已使用的扩展会扩展。我们的浏览器自动化与网页抓取工具比较涵盖了托管云浏览器与无代码和代码驱动自动化的区别。
该领域的一个相邻选项是AdsCrawl,一个托管云浏览器和浏览器自动化API。它将Playwright、Puppeteer或任何CDP客户端连接到真实的云Chromium浏览器,并具有住宅代理路由,返回渲染后的HTML、Markdown、JSON或截图。它不是浏览器扩展,不属于此排名,但当基于扩展的工作流遇到上述IP、调度或JavaScript渲染天花板时,它就变得相关。需要从动态页面大批量获取结构化输出的团队可以查看顶级云浏览器自动化和网页数据提取API以进行类别适当的比较。
实用选择建议
First viewport screenshot of How to crawl and scrape a website | Data Miner.
How to crawl and scrape a website | Data Miner 的首屏截图。
从能完成工作的最小工具开始。如果单次导出就能解决问题,使用Instant Data Scraper或Easy Scraper并就此停止。如果下个月还需要相同的提取,选择带有保存定义的工具:Web Scraper的站点地图或Data Miner的配方。
如果数据必须落入应用程序而非文件,Simplescraper的API输出避免了手动导出步骤。如果任务必须无人值守运行,云执行是不可协商的,Browse AI或Web Scraper Cloud是该类别中的自然候选。
根据数据量而非功能来制定预算。每月500页的上限和9,000页的计划在价格上相差约十八倍,正确的选择完全取决于你实际拉取多少页。
相关阅读
- 如何将AdsCrawl与Price2Spy®结合用于价格监控 - 了解AdsCrawl的云浏览器API如何将渲染后的竞争对手数据馈送到Price2Spy以实现可靠的价格监控,包含设置步骤和示例。
- AdsCrawl vs Parallel vs Remote Browser:AI代理网络栈 - AdsCrawl vs Parallel vs Remote Browser比较:渲染提取、搜索和研究API,以及用于AI代理浏览器基础设施的远程CDP会话。
- AdsCrawl vs Incogniton:云浏览器API还是反检测浏览器? - AdsCrawl vs Incogniton比较:带CDP API的托管云Chromium与用于多账户配置文件的反检测浏览器。看看哪个适合你的工作流。
来源与进一步阅读
- 2026年8款最佳网页抓取浏览器扩展 | Web Scraper - 八款网页抓取浏览器扩展的实用比较,涵盖一次性提取、可复用抓取器配置、多页导航、云执行、扩展和阻止
- 6款最佳网页抓取浏览器扩展 - 按定价、功能和Chrome Web Store评分比较2026年6款最佳网页抓取浏览器扩展,从Instant Data Scraper到Easy Scraper。
- 2026年13款最佳网页抓取工具 - 跨AI、无代码、Python、浏览器自动化和云浏览器平台的最佳网页抓取工具——Firecrawl、ScrapeGraphAI、Crawl4AI、Octoparse、Beautiful Soup、Scrapy、Selenium、Playwright、Puppeteer、Apify、Browserless、Hyperbrowser等,诚实比较。
常见问题
什么是网页抓取浏览器扩展?
它是一种浏览器附加组件,从你当前查看的页面提取结构化数据,并导出到文件或电子表格。它在Chrome、Edge或Firefox内运行,通常无需代码。
网页抓取浏览器扩展免费吗?
许多是免费的。Instant Data Scraper免费且无使用上限,Web Scraper提供无限本地抓取且不收费。Data Miner、Simplescraper和Bardeen使用免费层,在付费计划开始前有每月页面或积分限制。
浏览器扩展能抓取JavaScript密集型网站吗?
可以,因为它在已经渲染页面的真实浏览器中运行。限制不是渲染而是规模:扩展无法轮换代理或无人值守运行,因此被阻止或非常大的任务无论页面渲染得多好都会失败。
何时应从扩展切换到抓取API?
当你需要定时运行、代理轮换或超出浏览器标签页处理能力的数据量时。扩展是为交互式、人工发起的提取而构建的;API是为无人值守管道而构建的。
这些扩展能与Google Sheets配合使用吗?
有几款可以。Data Miner直接导出到Google Sheets,Simplescraper支持Sheets以及JSON和webhooks。其他导出到CSV或Excel,你可以手动导入到Sheets。
哪款扩展最适合多页爬取?
Web Scraper,因为其站点地图模型将导航层级、分页和详情页逻辑存储在一个可复用定义中。Data Miner和Simplescraper也分别通过配方和深度抓取支持多页工作。
结论
2026年最佳的网页抓取浏览器扩展取决于你需要速度、可复用性还是输出目标。Instant Data Scraper和Easy Scraper在速度上胜出。Web Scraper在可复用的多级配置上胜出。Data Miner在现成配方上胜出,Simplescraper在数据需要到达应用程序而非文件时胜出。
选择能完成工作的最小工具,并将云执行视为单独的决定。扩展是交互式、适度数据量提取的正确答案。当任务需要按计划运行、从轮换IP运行,或针对拒绝简单请求的网站运行时,诚实的做法是升级到云浏览器或自动化API,而不是将扩展拉伸到超出其构建目的的范围。